AI 聊天机器人前置分类器失败时:把拒绝、暂不可用和恢复做成可复现的状态
用一个零联网、可下载的 Python 小实验注入分类器超时、每日预算耗尽和误拦截,比较 fail-closed、fail-open、重试与精确恢复规则。
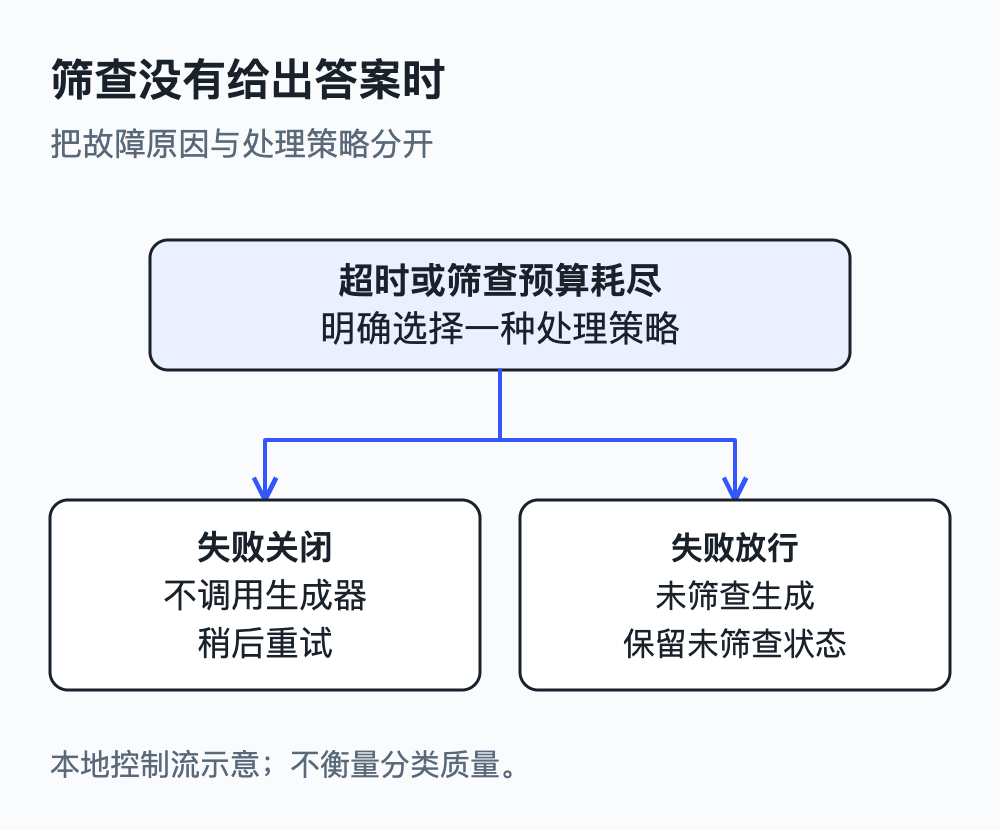
聊天机器人把筛查放在生成器前面以后,真正需要先定下来的往往是故障路径:分类器没有响应、当天筛查额度已经耗尽,或者一条普通问题被判成了需要阻断。每种情况都可能让页面只剩下一个模糊的“出错了”,却没有说明生成器是否已经被调用、还剩多少预算,也没有给出可验证的恢复入口。
这篇文章把范围压成一个本地实验:一个可控筛查 stub、一段可控生成 stub 和十条固定运行记录。它比较 fail_closed 与 fail_open 在筛查不可用时的控制流,保留误拦截后的精确恢复规则,并把分类器调用次数、重试次数、预算变化和生成器调用状态写进 JSON。下载包在本机运行,不连接推理服务。
下载 Classifier Failure Lab v1.0.0。包内有 Python 标准库脚本、实际 results.json、英文结果查看页和运行说明。
原问题来自一个作者自报的实现
这次实验的起点是 Reddit 原帖。原帖作者自报其戏仿聊天机器人使用 Workers AI 的 Llama 4 Scout,生成部分最多一到三句、130 token,并将笑话和安全检查分别放在两个每日硬上限之下;作者把最坏情况描述为约 $21/day。这些是来源作者对其系统和封顶成本的陈述。它们没有被当作当前模型报价、本文成本或分类质量保证。
作者还描述了先做正则匹配、再调用有独立预算的分类器;分类器不回答时就不生成回复。其问题是:
when screening sits in front of something meant to be offensive, do you fail closed and eat the false alarms, or fail open?
原帖也给出两个很有价值的边界:词尾匹配曾反复漏掉变形词;另一边,why are you so mean? 这样的站点问题会被误读为需要保护的披露。这篇文章不复跑原系统,也不尝试判断哪些内容应被分类。它用这两个工程问题来设计可复现的状态与恢复检查。
| 来源中的陈述 | 本地实验实际做的事 | 仍然未知 |
|---|---|---|
| 分类器有自己的每日预算,失去响应时原作者不出回复 | 用整数预算和脚本化 timeout 模拟调用边界 | 真实分类器的延迟、限额和质量 |
| 原作者使用 Llama 4 Scout,单次生成最多 130 token | 生成器只返回固定的 LOCAL_STUB_REPLY | 任何真实模型输出或价格 |
| 普通站点问题会被误拦截 | 为完整匹配的问题加入一条显式恢复分支 | 其他问题是否适合旁路 |
先把故障状态和确定性阻断分开
fail_open 只处理“筛查服务无法给出决定”这类状态。分类器已经明确返回 block 时,两个策略都保持阻断,生成器不会因为策略名称里有 open 就被调用。这样才能区分服务故障与一次明确的筛查判断。
本地脚本使用三个可注入结果:allow、block 和 timeout。每次分类器调用都会消费一个本地预算单位;超时最多重试一次。fail_closed 会返回 temporary_unavailable,并保留请求走到哪一步的轨迹。fail_open 会调用 stub,同时把结果标为 generated_without_screening,让这条风险路径在结果文件中可见。
对于误拦截,样例没有把所有 block 改成允许。它仅对完整等于 Why are you so mean? 的测试输入匹配一条“经审阅的完整问题”规则。Why are you so mean now? 这样的近似文本不会旁路,它仍会进入分类器并保持阻断。该分支在调用分类器前运行,记录 bypassed_by_exact_recovery_rule,并保留预算。这个设计让恢复条件本身可以接受代码审查和回归测试。
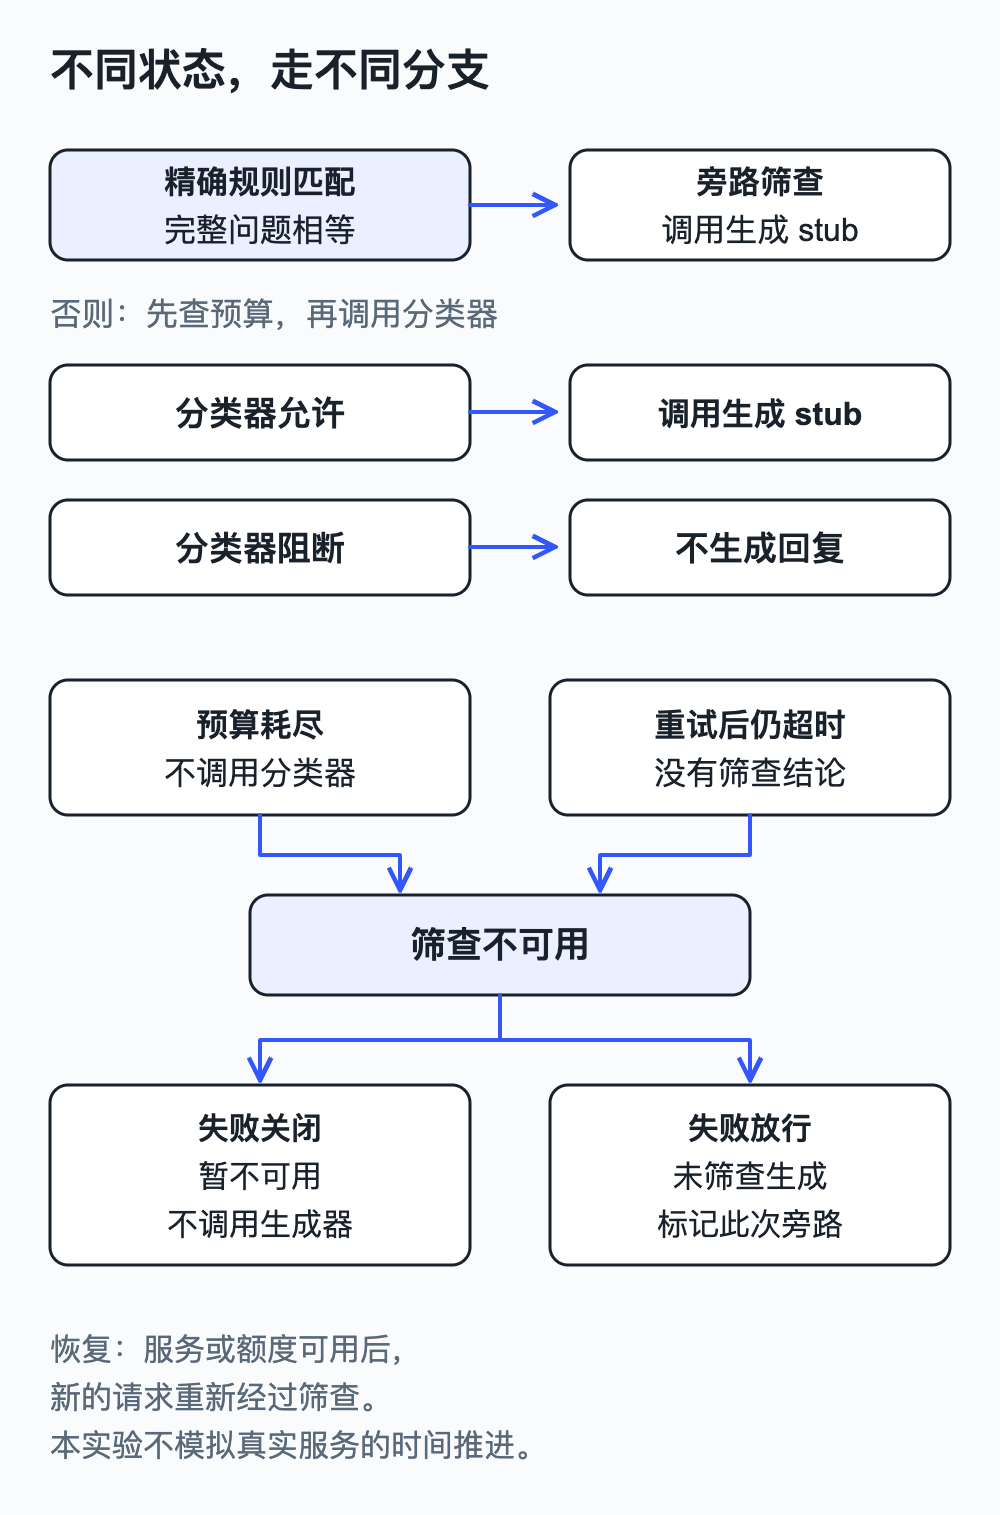
图 1:明确阻断、筛查故障和误拦截恢复使用不同状态。图中的“恢复”表示一次新的请求获得可用筛查或新预算,并不模拟真实服务的时间推进。查看原尺寸图。
十条实际记录把重试、预算和生成器调用放在一起看
在 Python 3.9.6 上运行 python3 lab.py --self-test --output results.json 后,七条从公开行为出发的契约全部通过,并写出十条 JSON 记录。每一行都是单独的有限输入,budget 显示本地筛查预算的前后值。
| 注入情形 | 策略或恢复路径 | 分类器调用 / 重试 | 预算 | 生成器 | 响应状态 |
|---|---|---|---|---|---|
| 两次超时 | fail_closed | 2 / 1 | 2 → 0 | 否 | temporary_unavailable |
| 两次超时 | fail_open | 2 / 1 | 2 → 0 | 是 | generated_without_screening |
| 每日预算已耗尽 | fail_closed | 0 / 0 | 0 → 0 | 否 | temporary_unavailable |
| 每日预算已耗尽 | fail_open | 0 / 0 | 0 → 0 | 是 | generated_without_screening |
| 普通问题被判阻断 | fail_closed | 1 / 0 | 2 → 1 | 否 | blocked_by_classifier |
| 普通问题被判阻断 | fail_open | 1 / 0 | 2 → 1 | 否 | blocked_by_classifier |
| 精确恢复规则匹配 | exact_recovery_rule | 0 / 0 | 2 → 2 | 是 | generated_after_exact_recovery_rule |
| 恢复规则的近似文本 | exact_recovery_rule | 1 / 0 | 2 → 1 | 否 | blocked_by_classifier |
| 超时后的新请求,筛查恢复 | fail_closed | 1 / 0 | 1 → 0 | 是 | generated_after_allow |
| 新额度下的请求 | fail_closed | 1 / 0 | 1 → 0 | 是 | generated_after_allow |
前两对记录是策略差异所在:同样的 timeout 或零预算,失败关闭把用户留在可解释的暂不可用状态,失败放行继续生成并留下未筛查标记。普通问题的误拦截并不属于这两条故障分支,表中两个策略都保留 blocked_by_classifier。近似文本的行证明恢复规则确实检查完整输入。恢复行说明了另一件事:只有把旁路条件或新的可用筛查写出来,生成器调用才会重新出现。
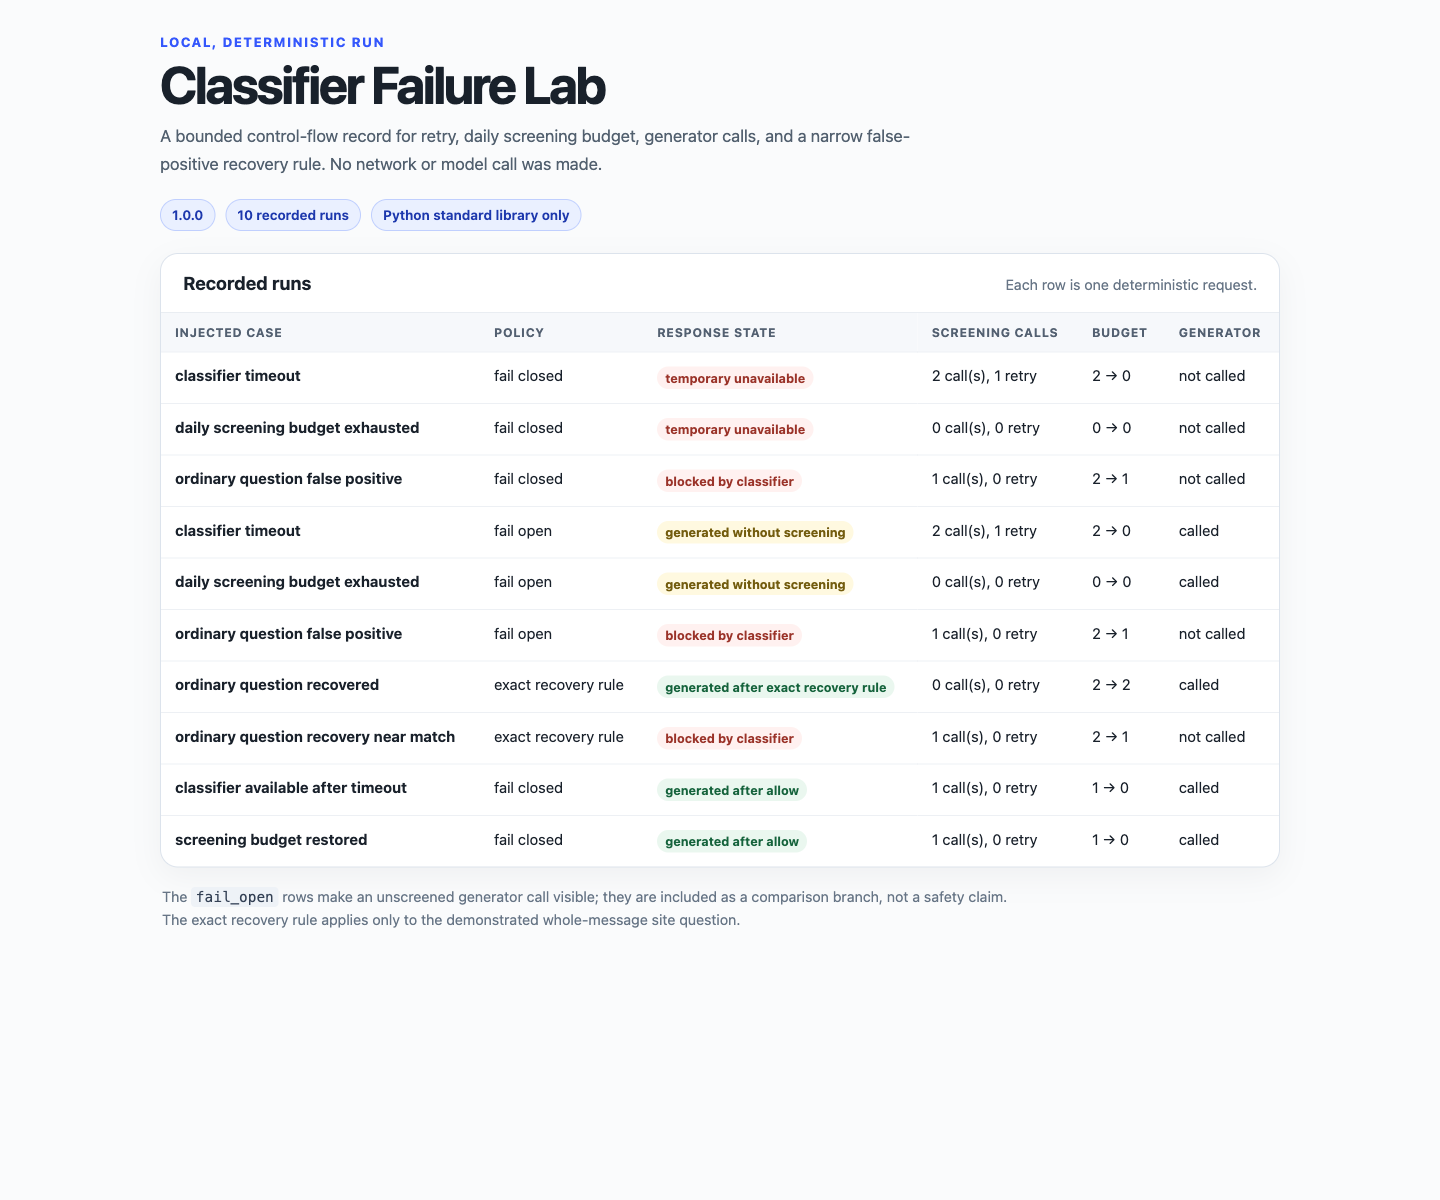
图 2:本地英文查看页直接读取本次运行生成的 results.json。黄色状态表示未筛查生成,红色状态表示明确阻断或暂不可用,绿色状态表示允许或精确恢复后的 stub 调用。查看原尺寸图。
可下载样例怎样复跑
解压下载包后,只需要 Python 3.9 或更高版本:
python3 lab.py --self-test --output results.json
python3 -m http.server 4349 --bind 127.0.0.1
第二条命令仅在当前目录提供静态文件。打开 http://127.0.0.1:4349/viewer.html,英文查看页会加载同目录的 results.json。脚本没有安装依赖、没有访问网络、没有读取凭据,也没有向外部模型发送输入。
行为契约检查的是读者和调用方能观察到的结果:失败关闭没有生成器调用;失败放行记录了未筛查生成;预算为零时没有隐式分类器调用;明确阻断仍然阻断;精确恢复规则不消费预算;服务或额度恢复后的新请求重新经过允许路径。测试没有断言某个内部函数必须存在,因此可以在保留同一状态契约的前提下调整实现。
让用户得到下一步,而不是只看到一个错误
如果你的产品要求筛查结论才能继续,temporary_unavailable 应当靠近输入和发送动作,告诉用户本次请求没有进入生成器,并提供稍后重试的入口。重试需要计入预算和运行记录;否则一次超时很容易悄悄变成多次调用。
如果业务确实选择失败放行,就把 generated_without_screening 作为可查询状态保存下来,而不是把它混进普通 allow。这让后续审计能区分“分类器允许”和“系统没有得到分类器结论”。误拦截的修复也应保持窄:从一个可解释的完整模式开始,保留触发样例和回归记录,再决定是否有证据扩大范围。
如果你的问题更接近表单、计算或本地草稿的回归边界,可以继续看小型 Web 项目上线前:用两个真实失败挑出最小测试。它用另一个本地样例把用户可见的失败、恢复和最小行为契约串成一条测试路径。
这个样例证明的是十条本地控制流都按预期留痕。真实分类器的覆盖范围、准确率、时延、成本和用户体验仍要在相应产品环境里单独测量。