Anthropic Scion 如何重做版本控制:架构解析与 OpenScion 实例
从只需一个目录的 CI 任务出发,理解 Anthropic Scion 的 changeset、服务端计算和对象缓存,再用 OpenScion 固定版本运行稀疏克隆与提交。
一个 CI 任务只要运行 services/api/ 的测试。一个 AI agent 只要改这个目录下的一个文件。它们需要的是当前版本的一小片代码,结束后工作区就会被丢弃。如果每次启动都要取历史、准备索引、处理整个仓库的对象,任务还没开始,版本控制已经花掉不少时间。
Anthropic 在 2026 年 10 月 13 日公开了内部版本控制系统 Scion 的设计:把历史查询、提交和合并移到服务器,以文件变化记录工作,再让客户端按需取目录树和文件对象。这套系统已经用于其内部 monorepo。公开的 OpenScion 则由 tinyhumansai 维护,沿着这篇设计文章做早期实现,可用于阅读源码和运行小样本;它不是 Anthropic 发布的 Scion 源码。
理解这次设计,最有用的入口就是这个小任务:客户端只需要 services/api/,服务端要做哪些事,才能让它不用准备完整仓库?
先看工作负载,才能理解为什么换系统
据 Anthropic 的第一方工程文章,其平均每日合入变更从 2026 年 5 月约 2,500 次增长到 9 月超过 30,000 次。main 分支历史接近 100 GB,压缩后的工作副本超过 25 GB。单是 CI,每天就有约 2,500 万次代码 checkout,尚未计入开发环境、agent 沙箱和研究任务。
原文估算,如果这些 checkout 都直接拉取代码,每天数据量会超过 600 PB。这是没有相应优化时的条件估算,实际运行中,Anthropic 已经用过浅克隆、稀疏 checkout、promisor remote、内部镜像和放在对象存储里的仓库快照。它在高峰时维护数百个 Git 镜像。
这些优化缓解了取代码的压力,也带来持续维护工作:快照刷新后很快落后于 main,部分克隆中的 diff、blame 等操作仍要正确处理缺失历史和对象。随着合入变更增加,镜像的磁盘、内存和同步成本继续增长。
Git 的完整副本适合离线查看历史、计算 diff、提交和分支操作。它也已有部分克隆与按需获取对象的机制。Scion 选择更彻底地把计算放到服务端,依据的是 Anthropic 的特定条件:绝大多数客户端是始终在线的 agent 和任务,仓库很大,客户端数量多,工作区寿命短。
换成小团队的普通仓库,这些条件未必成立。把更多功能放到服务端,会增加在线依赖、服务运维和迁移成本。Anthropic 自己也明确说,Scion 不适合作为 Git 的通用替代品。
Changeset 保存文件变化,目录快照由服务端推导
假设 agent 修改 services/api/app.py,同时删除 services/api/legacy.py。Scion 创建的 changeset 会记录父 changeset、作者、说明,以及这两个路径的变化。更新后的文件内容以 blob 形式保存,changeset 中放它的内容地址;删除项则记录路径被移除。
这里的变化是文件级操作。即使一个文件只改了三行,changeset 引用的也是更新后的文件内容。
Anthropic 把 changeset 定义为 write-ahead log 中的条目。它保存相对于第一父节点的文件变化。相比之下,Git commit 的逻辑模型指向一棵目录树,从这棵树得到那次提交的文件快照。Git 会复用没变的文件与对象,所以快照也不意味着每次复制整个仓库;packfile 的差量压缩又属于物理存储层。这个区别在 Git 官方书籍中有清楚说明。
Scion 仍然需要某个版本的完整目录视图,否则客户端无法知道 services/api/ 有哪些文件。区别在于,root tree 属于服务端从 changeset 推导出的数据,逻辑上不必写入 changeset 本身。
对刚才的改动,服务端可以从父节点的 root tree 出发,重建经过 services/、api/ 的目录路径,继续复用未受影响的子树。于是两个问题有了不同的表示:
- “这次工作改了什么”由 changeset 表示。
- “这个版本有哪些文件”由推导出的目录树表示。
第一父节点也带来历史语义的选择。合并 changeset 可以有多个父节点,但文件变化以第一个为基准。Anthropic 的解释是,在采用 trunk-based development 的 monorepo 中,日常历史和 blame 主要关注 main 这条线。这是针对其开发方式的取舍,分支丰富的项目不应直接假定同样的历史视角足够。
变化记录回答改了什么,目录树回答这个版本包含哪些文件。图为简化示意。
把历史、diff 和合并做成服务
只记录变化,查询并不会自动变快。要回答“谁最后改了这一行”,服务端还需要 blame 结构;要回答“哪些变更碰过这个路径”,需要 path history;要快速处理提交之间的关系,需要提交图索引。
Scion 把这些结构统称为 derived data。每种数据递归地从父 changeset 的对应数据计算,可以提前生成,也可以在需要时补算。索引留在服务端,客户端不用了解其内部布局,服务器就能继续优化查询,而不要求所有客户端升级仓库格式。
对 CI 来说,这会改变一次任务的起点。如果只是判断当前变更影响了哪些构建目标,可以直接向服务端请求它与 merge base 的 diff。如果任务只要分析提交祖先关系,也可以调用 API。只有真的要执行代码、编译或读文件的任务才需要工作副本。
写入也走服务端。客户端提供变化与内容对象,服务器创建 changeset,执行 rebase 或 merge。Scion 中没有 Git 那样先本地 commit、再 push 以共享提交的阶段。
但“创建一份工作”与“更新 main”依然是两件事。changeset 创建不会移动 ref。更新 ref 用的是单条 Spanner 记录上的 compare-and-swap:请求带着自己看到的旧值,只有旧值仍然匹配,才能换成新值。并发写入者不必为了保存各自的 changeset 共用一把全局提交锁;main 的移动仍有明确的一致性检查。
这种分离能减少全局可变状态,也要求审查、落地和测试流程配合。changeset 已存在,不代表已经通过审查或进入 main。
按对象读取,让节点之间共用缓存
现在回到 services/api/。客户端先拿到目标版本的 root tree,只沿着 services、api 这条路径请求需要的 tree,然后取该目录中的 blob。它没有必要遍历 web/,也没有必要把所有历史下载下来。
Scion 的协议围绕“我要哪些对象”展开。客户端查本地缓存,缺哪个 tree 或 blob 就按对象 ID 请求哪个。对象不可变,并以内容寻址,同一个 ID 可以由任意缓存层提供。服务端也不用为每个客户端计算一份不同的大型 packfile,或根据它已持有的对象重新做差量压缩。
Anthropic 的部署把对象读取分成几层:
- 同一台计算节点上的任务通过
scion-daemon共用对象。daemon 从周期快照启动,减少冷启动需要取的数据。 - 节点 daemon 向区域内的
scion-cache取 tree 和 blob。区域缓存可以直接从内存流式发送对象。 - 缓存未命中时,再请求权威
scion-server,由它从 Spanner 或云对象存储读取。
只有未命中的对象请求继续向下游传递,命中后沿原路径返回。
这几层使用相同的对象 RPC。不过 Anthropic 强制执行层次关系,避免区域缓存故障时,所有请求越级涌向权威服务器。内容寻址让缓存容易复用,故障隔离和流量控制仍要单独设计。
这也解释了两种容易混在一起的 checkout:稀疏 checkout 先选路径,虚拟 checkout 再延迟物化文件。 前者决定只获取 services/api/,后者让该路径内的文件内容在实际访问时才物化到本地。原文中的按需物化以文件与对象为单位。
FUSE 是把这类按需读取接到文件系统接口上的一种实现路径。OpenScion 的架构路线图把 FUSE 虚拟 checkout 列为未来阶段。Anthropic 这篇文章说明了 Scion 的虚拟 checkout 行为,未公开确认具体使用 FUSE;后面的 OpenScion 实例也只运行普通稀疏 clone。
服务端负责更多数据,也负责更多访问控制。Scion 支持仓库和目录权限,Antique 的审批规则可以区分注释改动与敏感逻辑。缓存能否给某个客户端返回内容,需要和权限模型一致;内容哈希保证对象身份,不会替代访问授权。
提速发生在哪些操作上
Anthropic 报告,各缓存层命中率超过 99%,Scion 基础设施的 CPU、内存需求比先前 Git 镜像体系小 200 倍,CI 获得了 25% 的 CPU 容量收益。200 倍对应基础设施占用,25% 对应 CI 容量;单次操作的耗时还要分开看。
原文的性能图给出了不同环境下的中位时间。几项与工作区准备直接相关的数据是:
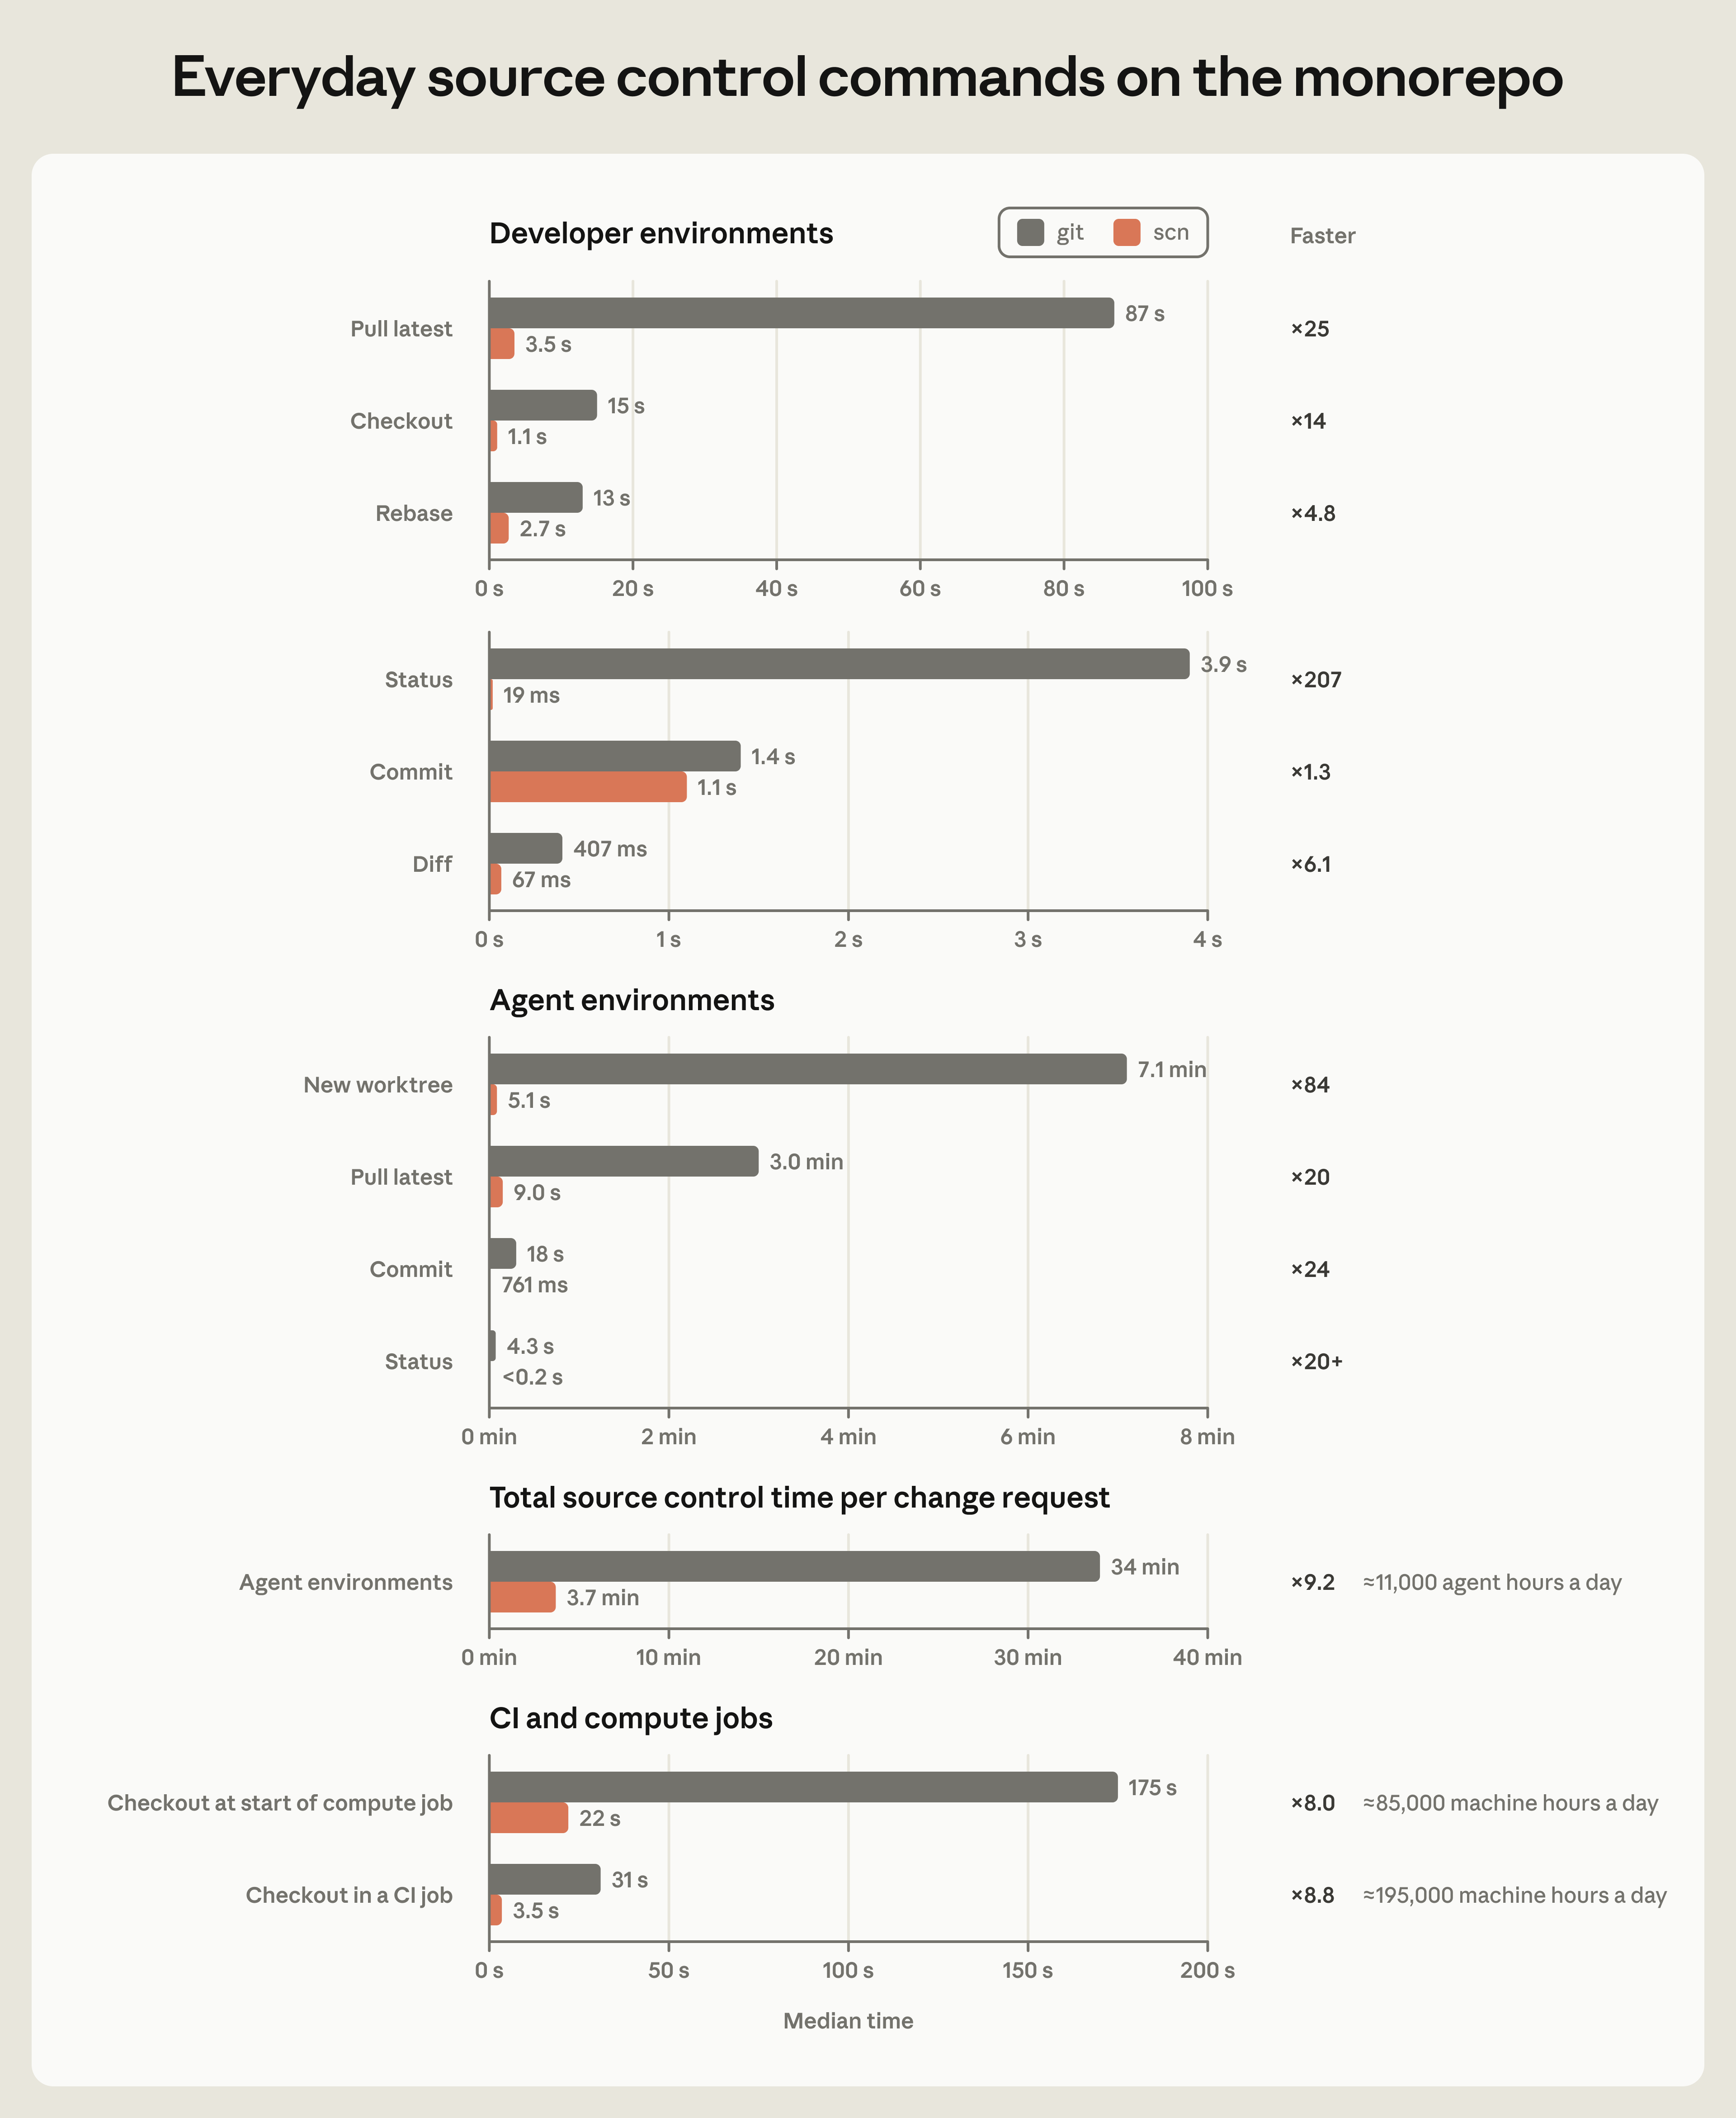
| 环境与操作 | Git | Scion |
|---|---|---|
| Agent 创建新 worktree | 7.1 分钟 | 5.1 秒 |
| Agent 每个 change request 的版本控制总耗时 | 34 分钟 | 3.7 分钟 |
| 计算任务启动时 checkout | 175 秒 | 22 秒 |
| CI checkout | 31 秒 | 3.5 秒 |
这些是 Anthropic 内部环境的数据。最大的变化出现在要准备大量文件与仓库状态的任务上;不同操作仍有不同收益。同图中,开发环境 commit 是 1.4 秒到 1.1 秒,约 1.3 倍。
工程流程也发生了变化。Anthropic 没有继续依赖全局 merge queue 锁,转而投入合并后和部署前的自动测试,接受并发变更可能产生冲突的事实。这需要可靠的检测与修复机制,不能把减少锁直接等同于保持了所有原有验收条件。
团队的工作同样保留了人工判断。七人团队在五个月内建设并迁移了 Scion、Antique 和多个相关系统,Claude 深度参与实现。原文给出的一个具体例子是 Git-to-Scion 导入管道重写,内存用量降到原来的 1/20、运行速度为原来的 4 倍。团队仍审查每个 change request,重点转向变更意图、系统约束与设计取舍,也会阻止 agent 因假设性问题加入过度复杂的代码。
用 OpenScion 看一小片代码怎样进入 changeset
OpenScion 让上述思路有了可以查看的公开代码。下面固定在 commit 00e92ab9c2a9985f39a64636b4b6c5c4bb583916,workspace 版本为 0.2.1,Rust 最低版本为 1.88,许可证为 GPL-3.0-only。
这个版本已经实现内存对象存储、changeset 日志、ref 比较交换、HTTP 接口,以及 opnscn import、commit、clone 和按目录 clone。服务器重启不会保留仓库,适合用临时文件看机制。
我们用三个文件做了一次本地运行:
README.md
services/api/app.py
web/index.html
先在准备好 Rust 的环境中获取固定版本并编译:
git clone https://github.com/tinyhumansai/openscion.git
cd openscion
git checkout 00e92ab9c2a9985f39a64636b4b6c5c4bb583916
cargo build --locked -p openscion -p openscion-server
在一个终端启动服务器,保持它运行。这里使用本机回环地址与 17878 端口:
./target/debug/openscion-server --listen 127.0.0.1:17878另一个终端仍在 OpenScion 仓库根目录,创建临时样本,导入后只克隆 API 目录:
SCION_DEMO=$(mktemp -d)
mkdir -p "$SCION_DEMO/tree/services/api" "$SCION_DEMO/tree/web"
printf '# Small monorepo\n' > "$SCION_DEMO/tree/README.md"
printf 'print("hello")\n' > "$SCION_DEMO/tree/services/api/app.py"
printf '<h1>Web</h1>\n' > "$SCION_DEMO/tree/web/index.html"

./target/debug/opnscn --server http://127.0.0.1:17878 \
  import "$SCION_DEMO/tree" --author demo -m 'initial tree'
./target/debug/opnscn --server http://127.0.0.1:17878 \
  clone "$SCION_DEMO/api-copy" --path services/api
这次运行分别返回 imported 3 files 与 cloned 1 files。api-copy 中的代码仍位于 services/api/app.py,不会被搬到根目录,web/index.html 和 README.md 没有物化到这个副本。
接着在这个稀疏副本改一个文件并提交,再取完整副本核对:
printf 'print("hello, Scion")\n' \
  > "$SCION_DEMO/api-copy/services/api/app.py"
./target/debug/opnscn commit \
  --dir "$SCION_DEMO/api-copy" --author demo -m 'edit one API file'
./target/debug/opnscn --server http://127.0.0.1:17878 \
  clone "$SCION_DEMO/full-copy"

cat "$SCION_DEMO/full-copy/services/api/app.py"
cmp "$SCION_DEMO/tree/README.md" "$SCION_DEMO/full-copy/README.md"
cmp "$SCION_DEMO/tree/web/index.html" \
  "$SCION_DEMO/full-copy/web/index.html"
commit 使用工作副本保存的服务器地址,所以这一步不必重新指定 --server。本次结果是 committed 1 changes,随后完整 clone 得到三个文件。API 文件包含新文本,另外两个文件的字节保持一致。
取回这次 changeset,也能看到它的 changes 数组只有一个 upsert,路径是 services/api/app.py。这验证了稀疏副本中的提交不会把没有取回的其他目录误判成删除。完成后在服务器终端按 Ctrl-C 停止进程;这里的内存仓库也随进程结束。
沿三段源码看清这个实例
变化类型定义中,文件变化是 Upsert { path, kind, blob } 或 Delete { path }。请求还带 parents、author、message 和 metadata。更新文件使用 blob ID,客户端与服务器可以核验返回内容是否对应这个 ID。
clone 的树遍历按层取树。在到达 services/api 之前,它只保留路径上的匹配项;到达过滤目录之后,才继续枚举下面的文件。随后批量取 blob、核验哈希并写入工作副本。这是“只请求要用的对象”的直接实现。
服务端创建 changeset会校验父节点与内容,推导 root tree,再把记录加入日志。目录推导实现沿修改路径加载子树,复用其他子树的 ID。它避免扫描所有子树,不过成本仍受路径深度、受影响目录大小和文件内容大小影响。
CLI commit 最后再以旧 base 为预期值移动 ref。如果别人先推进了 main,服务器返回冲突。我们另发了一次使用旧父节点作为 expected 的 ref 更新请求,实际得到 HTTP 409 RefConflict。当前实现会报告冲突,还没有服务端 rebase 与自动重试落地流程。
早期实现和完整系统之间还隔着什么
OpenScion 的 README 描述了服务器、节点 daemon、区域 cache 的完整方向。固定版本的路线图把 history/diff/ancestry 查询、rebase 和 landing 列在下一阶段;持久存储、Git 历史导入、daemon、网络缓存层、blame、虚拟 checkout 与访问控制仍有后续工作。
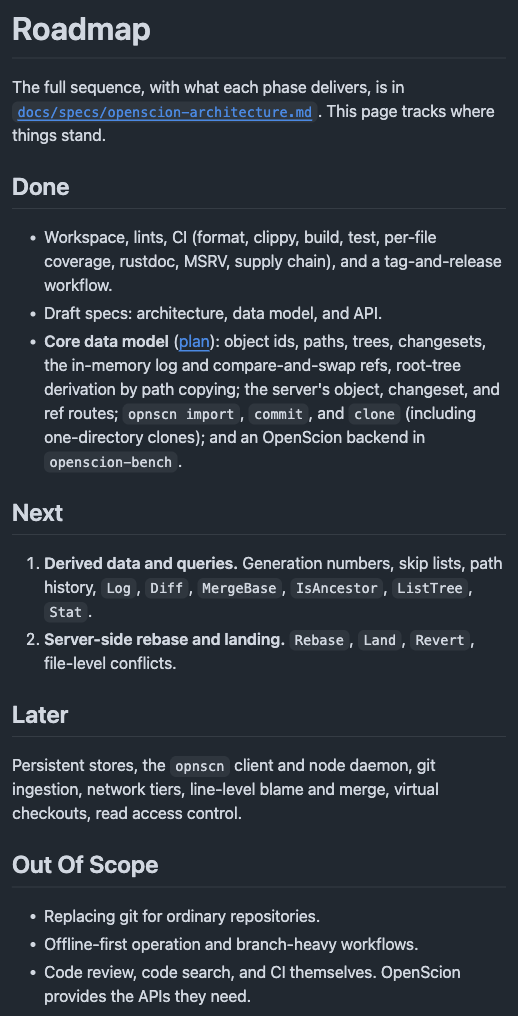
OpenScion 的英文路线图。当前可运行部分与后续规划分别列出。
当前 HTTP 服务器使用 Arc<RwLock<Repository>>保护单个内存仓库。它已经把 changeset 创建与 ref 更新分开,但尚不能按 Anthropic 的生产系统描述为分布式、无全局锁的部署。本例只监听本机回环地址。TLS 与访问控制仍需后续实现。
仓库中的性能对比使用 4 KiB 文件构造 1,000 与 10,000 文件的样本。作者明确说明,OpenScion 在内存中存数据,不进行持久化或压缩;Git 则写磁盘、压缩对象并生成 pack。OpenScion 后端还在进程内运行客户端,而 Git 命令有进程启动开销。那些时间可以观察目录切片的工作形状,不能直接当作生产系统的公平排名。这次小样本也只验证了文件与 changeset 行为,没有进行吞吐压测。
对已有 Git 流程,Scion 最容易借鉴的地方是先减少无用工作:统计 CI 准备仓库花了多久、实际读取哪些路径,把只需元数据的任务改成查询服务,让重复任务复用不可变对象。只有这些工作仍无法满足一个巨大 monorepo 的需求时,才需要进一步评估更换数据模型,以及随之而来的审查、搜索、权限和 CI 迁移。