随机 ID 的熵与长度如何选择
用 32 符号字母表推导随机 ID 的字符数,核对分组长度、碰撞概率和浏览器实现。
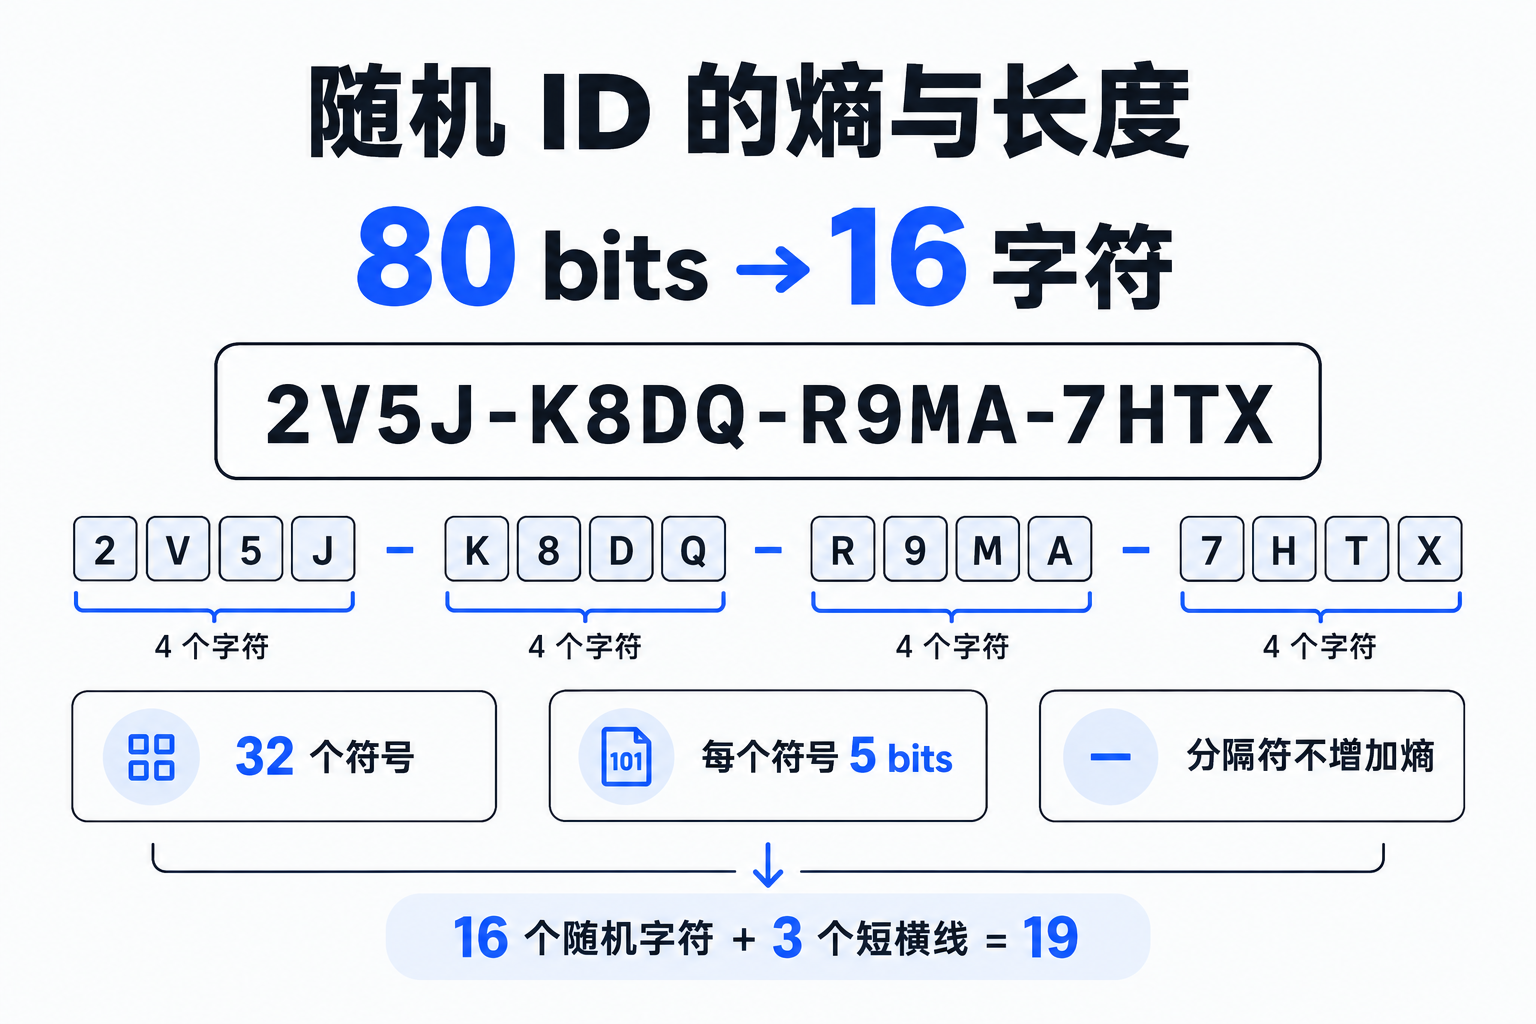
把随机 ID 缩短之前,先问一个具体问题:你需要生成多少个 ID,可以接受多大的碰撞概率?例如给一百万条导入记录分配 ID,选用 32 个符号的字母表,并让每个字符独立、等概率地生成,80 bits 的随机熵需要 16 个随机字符。插入三个短横线以后,屏幕上是 19 个字符,随机空间仍然只有 2^80 种。
打开随机 ID 工具,输入请求 bits 和生成数量,能同时看到请求熵、实际随机熵、随机字符数与分组显示长度。下面用这个实现把长度、随机源和碰撞风险接起来,便于在真实项目里选择参数。
从 bits 算出随机字符数
本工具固定使用 Crockford 的 32 个编码符号:
0123456789ABCDEFGHJKMNPQRSTVWXYZCrockford 的 Base 32 说明列出了这组编码符号:10 个数字加 22 个大写字母,去掉 I、L、O、U。这里生成的字符不会包含这些字母,也不附加可选校验符号。若每个符号均匀生成,单个符号有 log2(32) = 5 bits;若字符之间独立,L 个字符的空间为 32^L,随机熵为 5L bits。
需要至少 b bits 时,字符数 L = ceil(b / 5)。向上取整很关键:请求 81 bits 会得到 17 个符号,实际随机熵 85 bits。本工具始终生成完整的五位符号,所以请求 1 bit 也会得到 5 bits,请求 256 bits 则得到 260 bits。这里的“实际”是均匀独立随机源条件下的输出空间计算,并非对设备物理熵的测量。
| 请求 bits | 随机字符数 | 实际随机 bits | 含短横线的显示长度 |
|---|---|---|---|
| 1 | 1 | 5 | 1 |
| 5 | 1 | 5 | 1 |
| 80 | 16 | 80 | 19 |
| 125 | 25 | 125 | 31 |
| 256 | 52 | 260 | 64 |
工具每四个随机字符插入一个短横线,最后一组可以少于四个。分隔符数为 floor((L − 1) / 4),显示长度为 L 加分隔符数。19 个显示字符并不等于 95 bits,因为其中三个位置固定是短横线,不能产生新的选择。
在工具里核对一个 80-bit 结果
在英文工具界面保留默认的 Requested entropy = 80、Batch size = 1,然后点击 Generate IDs。摘要显示 80 请求 bits、80 实际 bits、16 个随机符号、19 个分组字符;下方出现四组四字符的结果。每次重新生成都会取新的随机字节,截图中的 ID 只是这一次操作的产物。
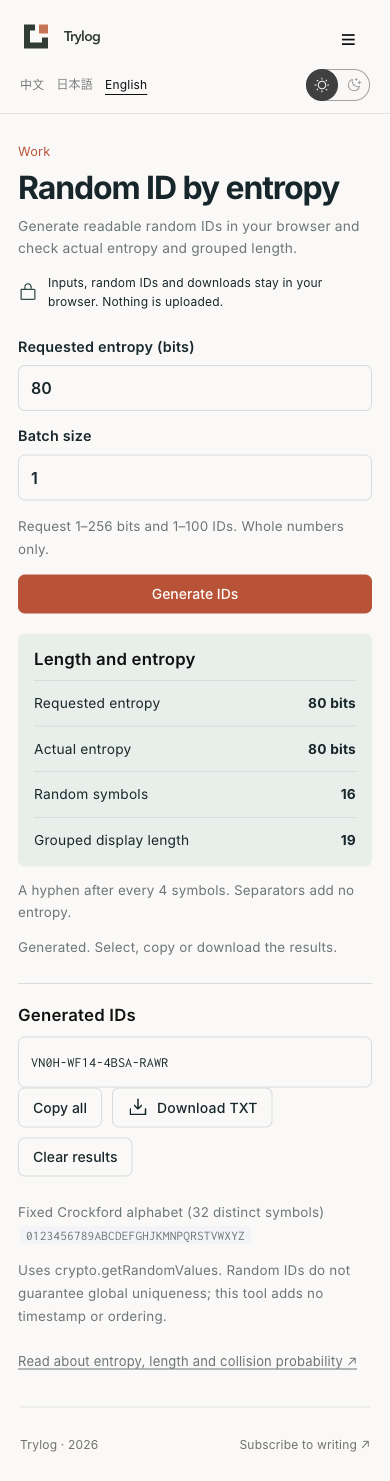
80 bits 对应 16 个随机符号;分组后显示 19 个字符。
把数量改成 100,再生成和下载 TXT,文件每行一个分组 ID。下载使用固定文件名 random-ids.txt。参数改变时旧结果会清空,避免把上一次的 ID 误认成新设置的输出;需要保留的结果先复制或下载。本次浏览器检查中,100 行下载与页面结果逐字一致,1、5、80、125、256 的边界结果也与上表吻合。
这些检查能发现计数、分组或导出错误。抽样一百条没有重复,无法证明均匀随机或全局唯一。均匀性需要从随机源与映射算法查起。
为什么这个字节映射没有偏差
浏览器端使用 crypto.getRandomValues 填充 Uint8Array。MDN 将它描述为密码学强度的随机值;浏览器一般使用由高熵来源播种的伪随机生成器。本文依赖浏览器提供的这一能力,没有把它包装成已测量的物理真随机设备。
每个输出符号使用一个独立随机字节,再取低五位作为字母表索引:
const alphabet = '0123456789ABCDEFGHJKMNPQRSTVWXYZ';
const length = Math.ceil(bits / 5);
const bytes = new Uint8Array(length);
crypto.getRandomValues(bytes);
const raw = Array.from(bytes, byte => alphabet[byte & 31]).join('');
const id = raw.match(/.{1,4}/g).join('-');
代码示意省略了输入校验;正式工具只接受 1–256 bits 和 1–100 条的整数。一个均匀字节有 256 种等可能值。对任意索引 k(0 到 31),k、k+32、一直到 k+224 这八个字节都映射到它,因此每个符号概率为 8/256 = 1/32。随机字节独立时,对各字节分别做这一映射仍保持符号独立。用完整的 0–255 输入逐个检查,可核对每个符号恰好出现八次;这个检查检验映射,随机源质量则由浏览器承担。
这个结论依赖字母表长度恰好为 32。若改成 36 个符号,直接 byte % 36 会有偏差:256 = 7×36 + 4,前四个索引有八个前像,另外 32 个只有七个。更换字母表时要重新设计无偏采样,例如拒绝超过最大整倍数的字节,不能原样沿用五位掩码。
工具最多一次请求 52×100 = 5200 个随机字节。随机源缺失或调用失败时,工具清空输出并明确报错;没有 Math.random 或服务端回退。实际模拟故障后恢复随机源,页面能重新生成。已加载页面断网也能继续计算,首次打开仍需要取得网页资源。复制可能受浏览器剪贴板权限限制,此时可以选择文本手动复制或下载。
一百万个 80-bit ID 的碰撞概率
把所有会相互冲突的生成记录都计入 n,包括多个设备、服务实例和时间段。在每个 ID 均匀、独立地从 M = 2^b 个可能值抽取的假设下,完全不碰撞的精确概率是从 i=0 到 n−1 的 (1−i/M) 连乘,至少一次碰撞的概率为 1 减这个连乘(n≤M)。
当 n 相对空间很小,可用生日问题的近似:
p ≈ 1 − exp(−n(n−1) / (2 × 2^b))如果 x = n(n−1)/(2×2^b) 远小于 1,进一步有 p ≈ x。取 n = 1,000,000、b = 80,独立计算得到 x = 4.135898926862076×10^-13,约为 4.14×10^-13。这里说的是这批一百万个 ID 中至少一对相同的概率,不是每个 ID 的概率,也不是“最多能生成多少个”的保证。请求 256 bits 时应把实际的 260 bits 代入本工具的模型。
反过来,在同样的小概率近似下,有了总量 n 和可接受的概率 ε,可以先估算 b ≥ log2(n(n−1)/(2ε)),再按五位符号向上取整。例如一百万个 ID、ε = 10^-12,估算需要约 78.73 bits,取 16 个符号得到 80 bits。80 是这个假设例子的选择;扩大总量、降低风险预算,或者需要对抗猜测时,都要重新考虑参数与完整安全设计。
数据库可以用唯一约束拦住重复,并在冲突时重新生成后重试。生成前先查询是否存在,在并发写入时仍可能竞态;唯一约束应落在真正接受写入的系统里。还应明确 ID 的冲突作用域:仅租户内部,还是所有租户共享;这会改变 n 的统计范围与约束设计。随机 ID 只降低碰撞概率,不能提供全局唯一保证。
接入系统时保留格式约定
决定数据库保存分组形式还是去掉短横线的原始形式,并在所有入口使用同一约定。本工具编码仅用大写字母。若接收人工输入,可另做去分隔符和大小写处理,但要明确允许的符号与规范化规则,避免不同客户端产生两种可见形式。短横线用于读写,并不是创建顺序;首版没有时间戳、单调递增状态或跨进程排序保证。
输入、生成结果和 TXT 在浏览器内处理,不写到页面 URL,不保存到浏览器长期存储,也不上传参与计算。网页初次加载需要请求站点资源;部署后的访问统计属于网页访问数据,不能包含这些输入和结果。刷新或离开页面会失去当前结果,需要留存时导出到自己的文件里。
jet-id 原帖提供了什么线索
jet-id 的 Reddit 原帖提出了按目标熵生成可读 ID 的任务。作者在正文中写了默认 125 bits,并展示 CLI 和 API 用法;80-bit 示例被标为 20 个随机字符、带短横线 22 个字符,默认示例标为 25 个随机字符、带短横线 28 个字符。
其中 80-bit 的 20 字符,与均匀独立的 32 符号理论长度 16 字符存在差异,原因在本次范围内没有核验。原帖关于开源、最短长度、速度、时间戳及单调 ID 的说法仍是作者陈述,本文没有审计其许可、实现或基准测试。本工具独立定义了字母表、映射和每四字符分组规则,125 bits 的显示长度也因此是 31;它不复现 jet-id 的格式或行为。
在项目里选长度时,把“总生成量与碰撞预算”写进参数决定,把“均匀独立随机源与固定格式”写进实现约定,再用唯一约束承担系统最终的拒重责任。这样得到的短 ID 才有可以核对的边界。