编码代理模型路由怎么评估 读懂 Weave Router 的质量、费用与耗时
审读 Weave Router 的公开 pass@2、每次尝试费用和耗时,核对版本与许可,并用对照表记录任务、缓存和失败。
把合格产物、费用和时间一起比较,缓存与失败也进入记录。
把编码代理从固定模型换成自动路由,通常是为了降低费用和等待时间。真正需要比较的,是同一批任务交付了多少合格结果,以及这些结果用了多少费用、时间和人工返工。便宜请求变多,不一定让完整任务更便宜。
Weave Router 的公开页面把这个问题做成了质量、费用、速度三个标签。本文实际查看了英文官网、公开仓库和基准说明,整理当前披露的指标,并给出可以复用的对照记录。这里的分数和费用来自项目方;本文没有运行付费模型测试,也没有修改现有编码代理的路由设置。
先读两套任务的成绩
官网说明,Router 与 GPT-6 Astra 使用相同 Codex harness、相同任务,每题两次尝试,并在同一天和同一 package 下配对比较。质量采用 pass@2:一题的两次尝试只要有一次通过,就算该题解决。费用和时间则按每次尝试展示。
| 公开质量指标 | Terminal-Bench 4.0 | SWE-Atlas |
|---|---|---|
| 任务 | 66 个终端工作流任务 | 124 个代码库问答任务 |
| Weave Router pass@2 | 62.1% | 62.1% |
| GPT-6 Astra pass@2 | 60.6% | 66.1% |
| 官网描述的任务差 | Router 多解决 1 题 | Router 少解决 5 题 |
| 按展示分数计算的差值 | +1.5 个百分点 | −4.0 个百分点 |
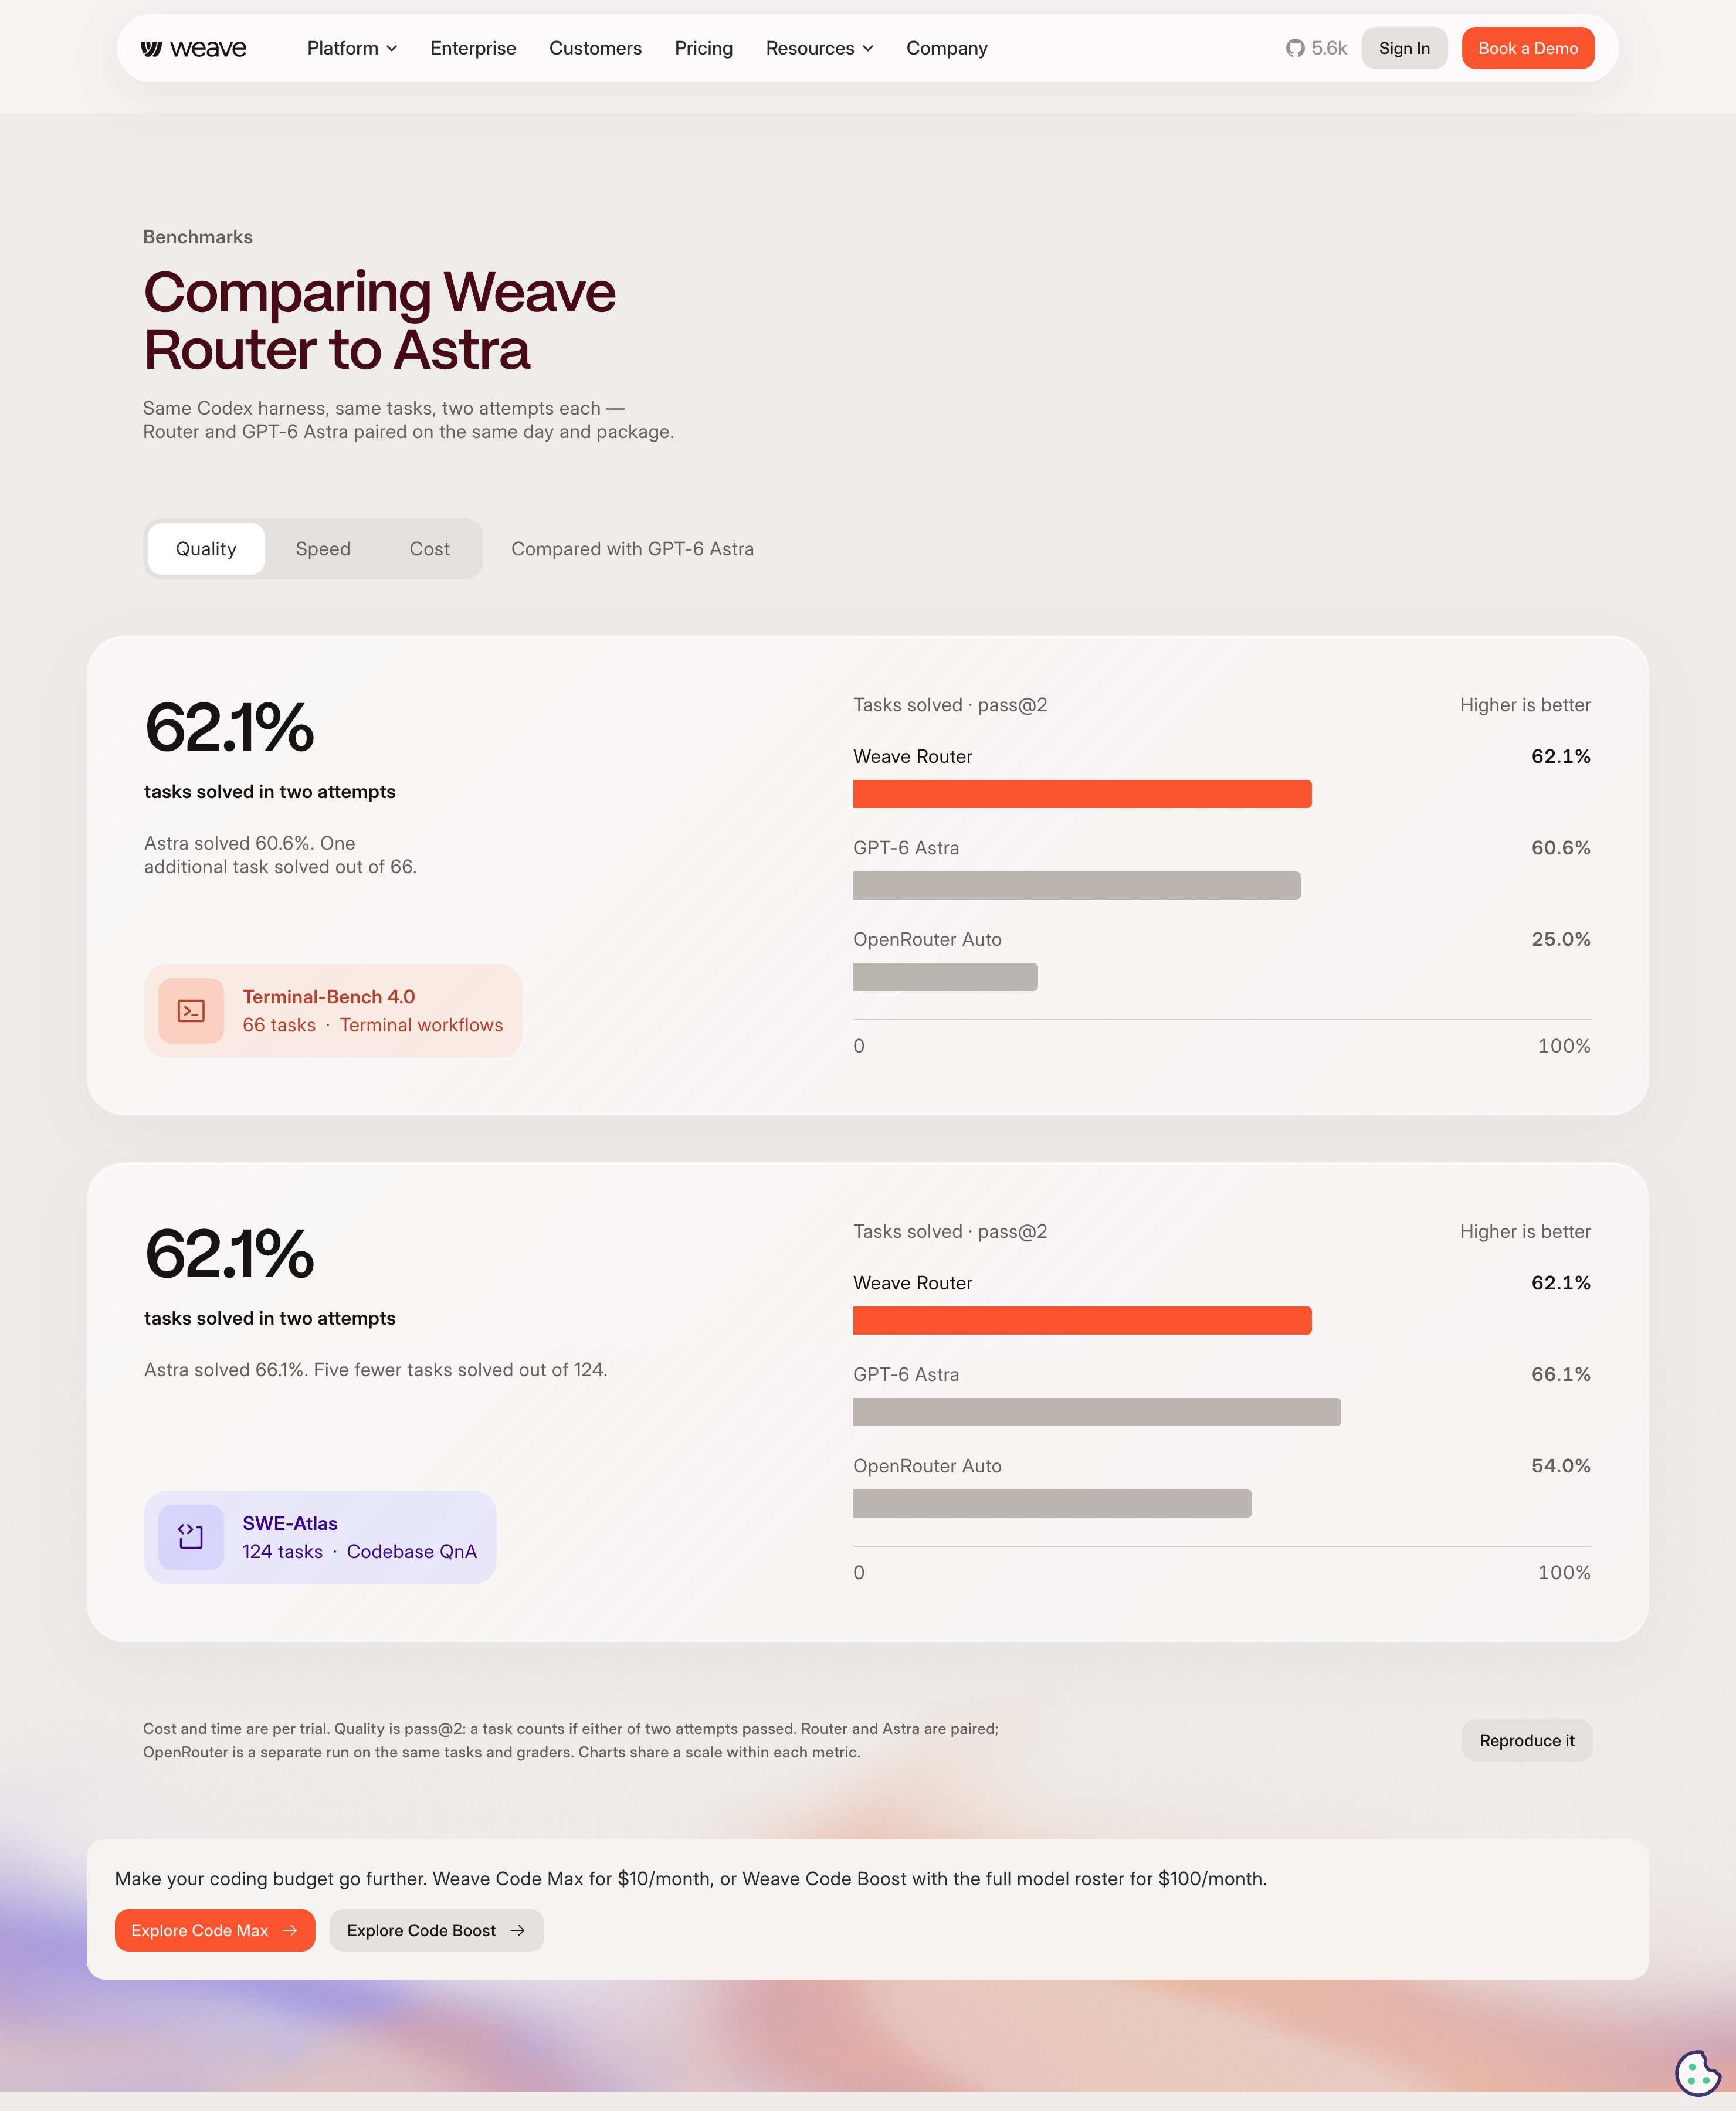
官网两组质量结果方向不同:终端任务多一题,代码库问答少五题。
两套任务的方向不同。Terminal-Bench 这一批里,Router 多解决一题;SWE-Atlas 里,Astra 多解决五题。仅凭这些点估计,无法证明两者在所有编码任务上等价,也无法判断差异是否超过抽样波动。需要配对的逐题结果、重复试验和不确定性区间,才能讨论预先设定的可接受质量损失。
pass@2 也不能当成单次成功率。一个系统可能第一次经常失败,第二次才补上;另一个系统可能第一次就完成,两次合并后的任务分数仍然接近。若你工作中只有一次预算,就应比较 pass@1。允许重试时,则把重试时间、费用和最后产物一起计入。
原始 Show HN 帖子中,作者用“等价通过率”介绍 Router 2.0,并给出 Terminal-Bench 成本为 Astra 的 52%、SWE-Atlas 为 54% 的说法。当前官网提供了更具体的两套分数,后文以当前披露的绝对数值为准;旧帖保留为发布时的作者陈述。
费用和速度的分母是什么
当前官网 Cost 标签列出 Terminal-Bench 每次尝试 $5.22 对 $10.03,SWE-Atlas $2.31 对 $5.04,前一个数字均为 Router。由这组数值计算,Router 分别约为 Astra 成本的 52% 和 46%,对应约减少 48% 和 54%。“成本为 54%”与“减少 54%”相差很大,引用时应保留分母。
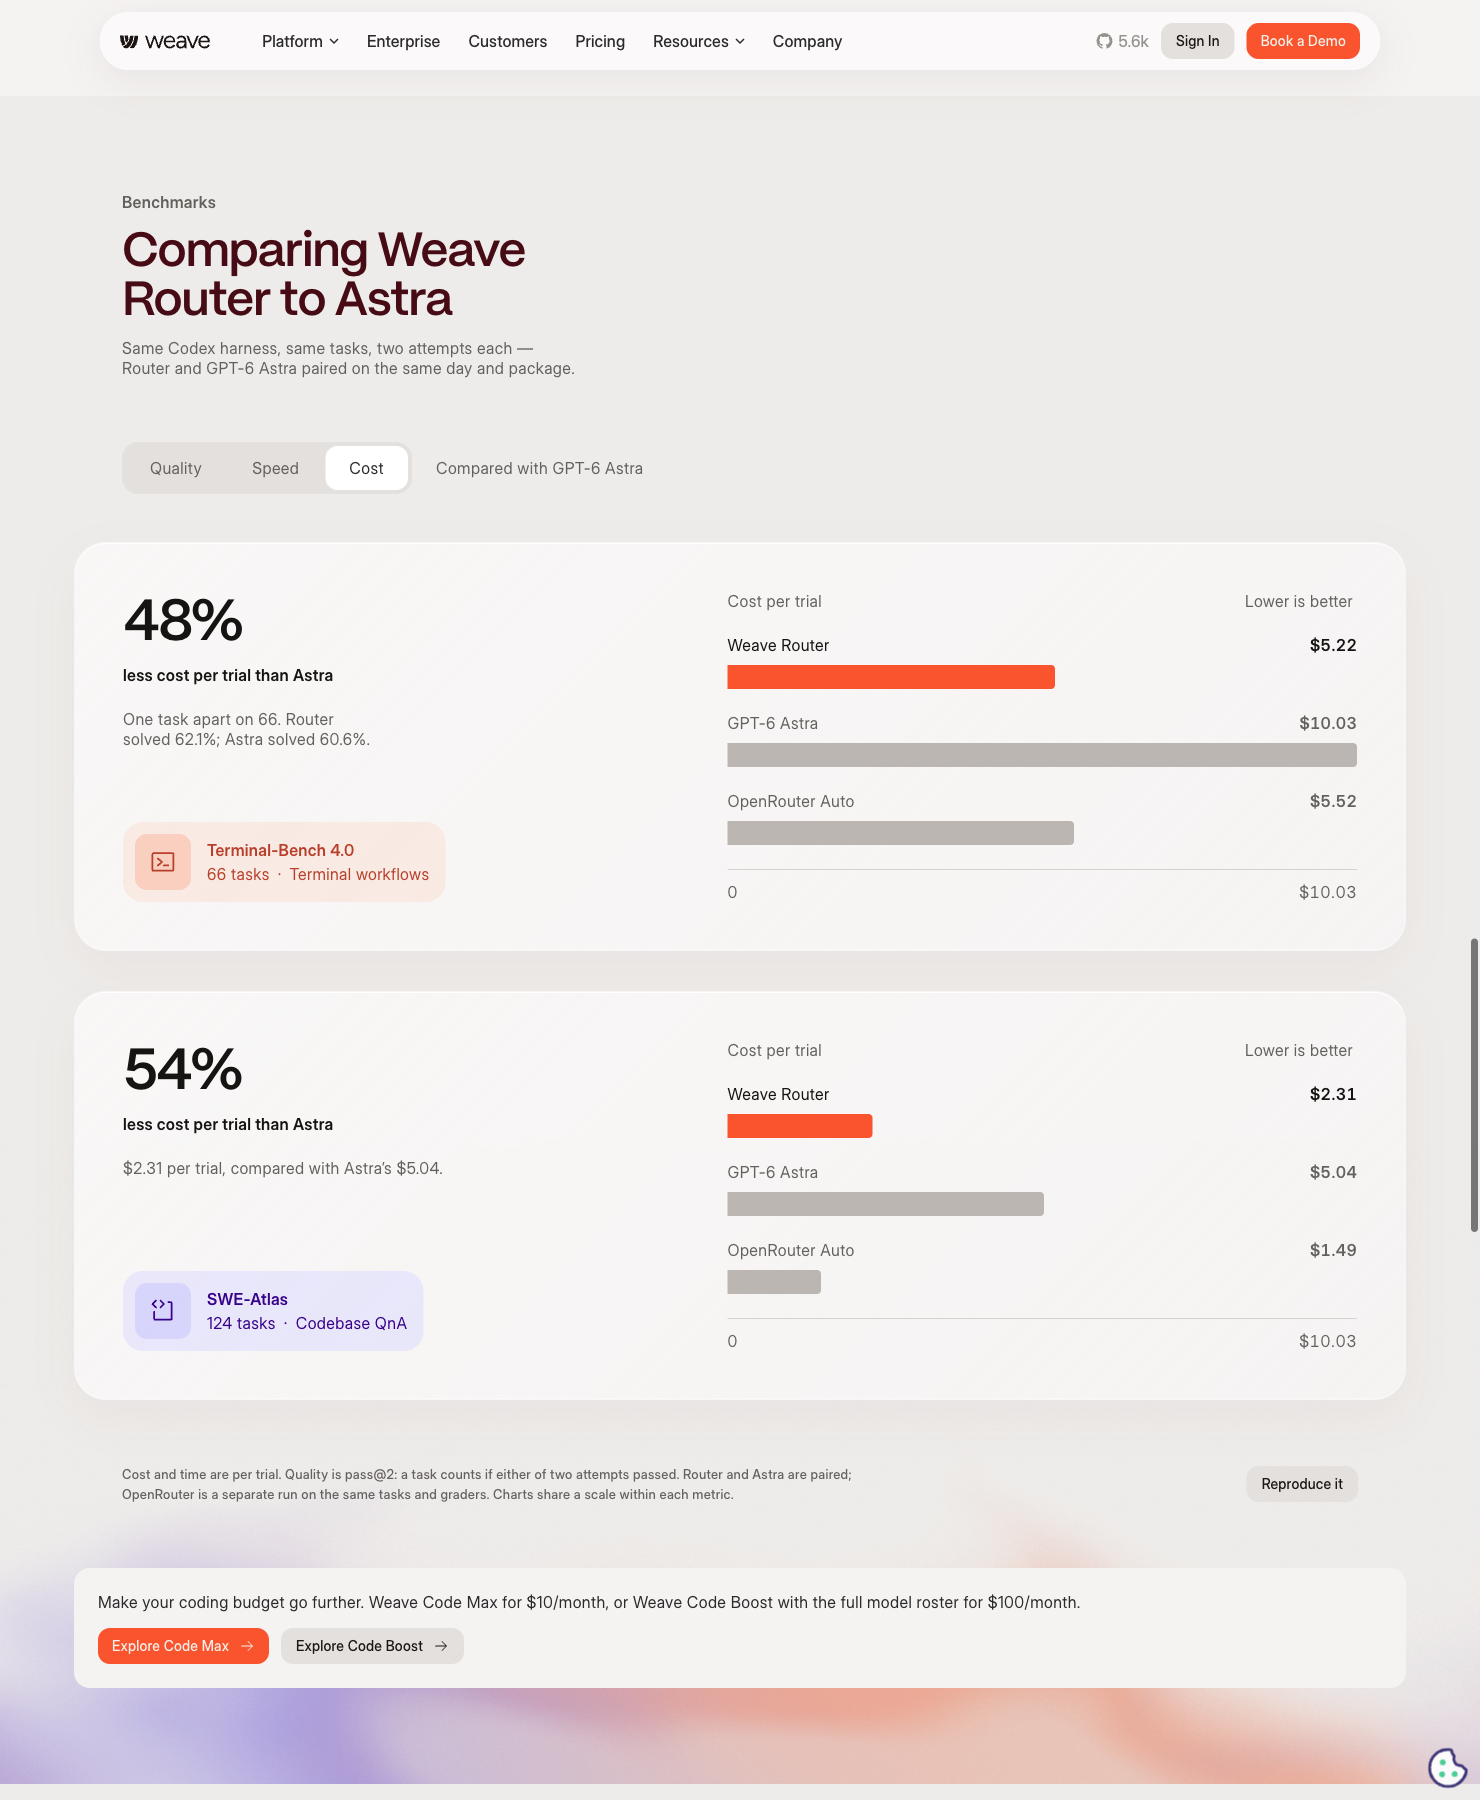
Cost 标签显示的是每次尝试费用,页下注明质量另用 pass@2。
Speed 标签列出 Terminal-Bench 每次尝试 20.5 对 44.1 分钟,SWE-Atlas 6.8 对 16.7 分钟。页面把两组比例概括为约 2.2 倍和 2.5 倍。它们描述这些基准中的每次尝试,不能直接代替一个包含排队、并发、环境准备和人工检查的项目所需时间。
官网还列出 OpenRouter Auto。其页下注明,这一组是相同任务和评分器上的独立运行,Router 与 Astra 则为配对运行。把三根柱子放在一起,仍需保留这个实验设计差别。
公开基准 README进一步区分了三种费用:Router 的分析导出提供按目录价格及缓存语义计算的 router-billed;直连模型用 Codex usage 乘价格表得到 list 估计;OpenRouter 使用其返回的 usage.cost。文档明确说 router-billed 不是 OpenAI 发票,直连侧看不到客户端未暴露的缓存写入。缺少分析权限或保存的导出文件时,Router billed 字段留空。
因此,复测时先选一个费用口径。需要评估现金支出,就保留账单与附加费用;需要比较模型资源消耗,就同时列出 token、价格快照和估计方法。路由服务费、订阅固定费用、自托管资源费以及 judge 费用分别登记,再给出总计。不要把一个组的目录价与另一个组的实际账单默认为同一件事。
缓存会改变切换模型的收益
编码代理的会话通常带着越来越长的历史、工具输出和文件上下文。切到另一个模型或提供商后,原有缓存不一定能继续复用;为了便宜一次请求而重建大量上下文,可能抵消该次请求的单价优势。一次错误选择还可能触发失败、升级和再次执行。
Weave 的官网把 cache-aware switching 和失败后升级列为路由机制;这是项目对机制的描述。公开 README 则明确默认自托管使用进程内 cluster scorer,可选的 frozen HMM sidecar 需要另行启用,Router 仍负责最终模型选择。不能只因客户端安装成功,就认为自己运行了官网所测的同一策略。
基准说明还提醒,OpenRouter 的 Responses 路径需要请求级 cache_control,缺少标记会改变缓存命中与费用;Router 的费用能包含缓存写入,而直连估计不一定可见。比较时把冷缓存与热缓存分开,记录缓存读取、写入、未缓存输入、输出 token,以及切换次数和实际服务模型。没有数据的项填“未知”,不能填 0。
固定版本和许可对象
本文核对的客户端标签是 router-v0.2.28,提交 d1dc0b78efef18a3631d0f44801c9a4ef1fab6e5;同时读取 main 提交 4387a1acd6446aa60ccb64bba3faca2b8a5ac87a。两处 LICENSE 都是 Apache 2.0,README 写明 Apache 2.0 发行线从 router-v0.2.24、npm 0.2.24 起,旧标签和已发行包保留随包许可。
官网本次阅读仍写着“Elastic License 2.0 to self-host”。这句文字没有在页面上明确指向上述标签、具体组件或下载产物,不能与固定提交的 LICENSE 合并为一个当前许可结论。选定要部署的发行包时,应检查那个包及附带通知的条款。
THIRD_PARTY.md也把项目代码、第三方依赖、模型权重和数据集分开。npm 安装器不包含服务端或模型权重。HMM sidecar 说明提供公开 frozen package 的下载及 hash 验证方式,同时排除训练、在线学习和内部注册系统;该 v1 包还要求匹配的 Google embedding。公开源码、可下载冻结产物和托管 Router 2.0 的完整训练与服务策略,分别是不同范围的材料。现有阅读无法确认它们完全相同。
用一张记录表对齐自己的任务
先选一小批能代表日常工作的任务,例如修复一个已有失败测试、实现一个明确需求、解释一段代码。固定仓库提交、输入与验收条件,然后在独立环境分别运行 baseline 和 router,防止前一个组的改动影响后一个组。两组保留相同工具、权限、尝试数、预算及超时;必须不同的模型参数如实登记。
| 记录组 | 每次尝试要保存什么 |
|---|---|
| 任务与环境 | task_id、需求和输入 hash、仓库 commit、环境镜像、harness 与评分器版本 |
| 路由与模型 | baseline/router、策略与 package digest、实际模型/提供商/版本、推理设置、回退和切换次数 |
| 执行约束 | attempt、重复或 seed、工具与权限、预算、超时、运行顺序、并发数 |
| 质量 | 测试命令和退出码、产物路径、验收判定、人工修改量、失败类型 |
| 费用 | 输入/输出及缓存读取/写入 token、价格快照、账单或估计、重试、服务/资源/judge 费用 |
| 时间与日志 | 开始/结束、端到端耗时、可用时的首 token/推理时间、冷/热缓存、日志路径 |
这张表把费用与产物绑定起来。环境启动失败、模型拒绝、工具失败、超时、答案错误应分别记,先报告全部任务,再按预先写好的规则给出附加分析。只删掉 Router 的困难失败,或只保留两组都成功的任务,会让比较偏向剩下的简单样本。
下面是尚未运行的双组模板,可复制到自己的记录表。not_run 是执行状态,unknown 是未获得的数据;它们都不是测试失败或零费用。
| 字段 | baseline | router |
|---|---|---|
| task_id | 自己的任务 ID | 同一个任务 ID |
| attempt | 1 | 1 |
| 执行状态 | not_run | not_run |
| 验收结果 | unknown | unknown |
| 总费用 USD | unknown | unknown |
| 端到端分钟 | unknown | unknown |
| 缓存读取/写入 | unknown | unknown |
| 失败类型 | unknown | unknown |
| 日志路径 | 待填 | 待填 |
聚合时同时保留每次尝试通过率、任务 pass@1/pass@2、配对的赢/平/输和质量差值。费用可以计算“全部尝试及附加费用之和 ÷ 合格任务数”,失败尝试的支出也在分子里;合格任务数为 0 时,这个指标没有可用的有限值。时间则分别报告单任务端到端耗时的中位数和 p90,以及整批从开始到完成的墙钟时间,并说明并发数。需要加入人工返工时,把人的检查和修改分钟单列。
预先确定你能接受的质量损失和预算,再决定是否扩大测试。对代码解释任务合格的路由,未必适合高风险修复;一批任务省下的费用,也未必覆盖下一批更长上下文的缓存重建。保留任务、版本、产物和日志,才能在模型池或策略更新后重新比较。更多具体工具与验证方法可在 Trylog 工具实测 阅读。