数据库优化 用 SQLite 查询计划验证复合索引
在 20 万条合成订单上比较 SQLite 复合索引前后的执行计划、有序结果和暖缓存重复耗时,附完整脚本与体积成本。
数据库优化可以从一条具体查询开始:保存数据与参数,读执行计划,加一个有理由的索引,然后核对结果和重复测量。本次用 SQLite 的 20 万条合成订单,查询某个客户的一段时间内最近 20 笔已付款订单。复合索引把计划从全表扫描加临时排序变成索引搜索;在这次暖缓存测量中,中位耗时从 4.837 毫秒降到 0.02254 毫秒,有序结果逐行一致。
这些数值来自一个本地读查询样例。下面保留完整输入、计划和测量方法,方便你在自己的环境里复核索引为什么有效。
固定数据与要回答的问题
表里有 1000 个合成客户、三种轮换状态,时间值每条递增 60 秒。每行保留 128 个 ASCII 字符的 note,用来让表具有一定宽度;查询不会读取 note。表结构与每行的生成规则如下:
CREATE TABLE orders (
  id INTEGER PRIMARY KEY,
  customer_id INTEGER NOT NULL,
  status TEXT NOT NULL,
  created_at INTEGER NOT NULL,
  total_cents INTEGER NOT NULL,
  note TEXT NOT NULL
);
# i ranges from 0 to 199999
row = (
i + 1,
i % 1000,
['paid', 'pending', 'cancelled'][i % 3],
1700000000 + i * 60,
100 + (i * 7919) % 100000,
'x' * 128,
)数据共 200000 行,使用固定公式而不是随机业务数据。金额保存为整数分;created_at 是合成 Unix 秒值,只用来定义范围和顺序。完整脚本在新建的临时数据库里插入这些行,不连接现有数据库。
要优化的查询及绑定参数是:
SELECT id, created_at, total_cents
FROM orders
WHERE customer_id = ? AND status = ? AND created_at >= ?
ORDER BY created_at DESC, id DESC
LIMIT 20;
params = (42, 'paid', 1703000000)它有三个筛选条件,还要求按时间与 id 倒序取前 20 行。id 作为第二排序项,让相同时间下的顺序仍有明确规则。本数据的时间各不相同,但保留这项规则能稳定表达查询含义。这组条件实际匹配 50 行,LIMIT 后返回 20 行。
先看查询计划 再决定索引列
在 Python 中用 connection.execute('EXPLAIN QUERY PLAN ' + query, params) 取得计划详情。加入索引前,实际输出是:
SCAN orders
USE TEMP B-TREE FOR ORDER BY
SCAN orders 说明当前读取整张表;USE TEMP B-TREE FOR ORDER BY 说明排序需要临时 B 树。SQLite 的 EXPLAIN QUERY PLAN 文档定义了这些标记,并提醒输出格式可能随版本改变。计划解释访问方式,实际耗时仍需测量。
这条查询首先固定客户和状态,再按时间范围筛选、按时间与 id 取最新记录。因此测试的索引按这个顺序安排:
CREATE INDEX idx_orders_customer_status_time
ON orders(customer_id, status, created_at DESC, id DESC);
加入后,计划变成:
SEARCH orders USING INDEX idx_orders_customer_status_time
(customer_id=? AND status=? AND created_at>?)
客户和状态的相等条件把搜索收窄到对应的索引区间,时间列进一步限制范围;后两列的顺序与 ORDER BY 一致,临时排序标记消失了。SQLite 查询规划文档的复合索引章节解释了同时支持搜索与排序的机制。
这个索引没有包含 total_cents,所以计划是 USING INDEX,并非覆盖索引;取金额仍需要访问表记录。本次先用足以改变访问路径的索引,更多列是否值得加入,要结合读写负载与体积再测。
先核对结果 再计时
脚本从同一份已填充、已执行 ANALYZE 的数据库复制出两份:一份保留原状,另一份创建索引后再执行 ANALYZE。两边打开独立连接,使用相同参数。首次查询得到的两个完整有序列表直接比较,后续每一次测量也与基准列表比较。
本次所有 20 行的 id、时间和金额都相同,顺序也相同。保存结果的 SHA-256 为 c79f414a4da97708ca6499630a96ab92bef4d7590ea698c2d95dc58671698570。hash 便于比对重跑结果,正确性检查用的仍是完整列表相等,而不是只比行数。
两边各预热五次,再把索引前、索引后各 30 次执行混在一起,用固定种子 714 打乱次序。计时只包围 execute 与 fetchall:
start = time.perf_counter_ns()
rows = connection.execute(query, params).fetchall()
elapsed_ms = (time.perf_counter_ns() - start) / 1e6
assert rows == expected_rows
插入数据、复制文件、创建索引、ANALYZE 和一致性断言都不计入查询耗时。fetchall 会真正取出所有返回行,避免只测准备查询的时间。
读出这次测量能支持的结论
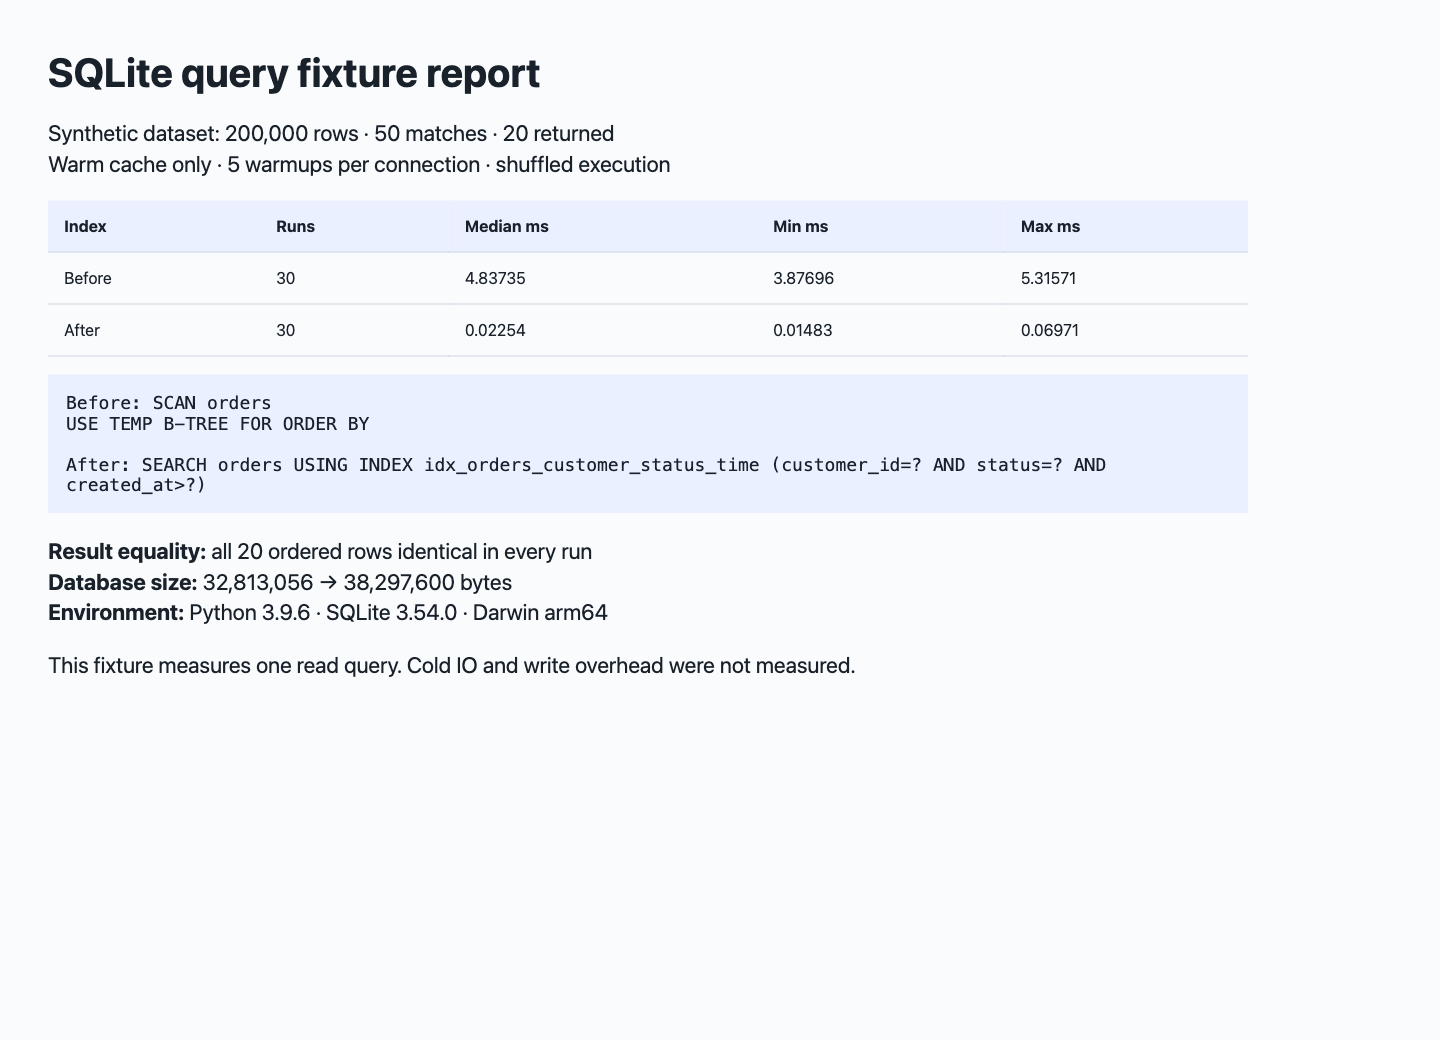
合成数据的本地报告,显示实际计划与暖缓存测量。
| 状态 | 中位数 毫秒 | 最小值 毫秒 | 最大值 毫秒 |
|---|---|---|---|
| 无复合索引 | 4.83735 | 3.87696 | 5.31571 |
| 有复合索引 | 0.02254 | 0.01483 | 0.06971 |
运行环境为 Darwin arm64、Python 3.9.6、SQLite 3.54.0,SQLite 页大小 4096 字节。每个连接的页缓存目标设为 65536 KiB;自动索引关闭,让对照明确聚焦这一个手动创建的索引。操作系统缓存没有清空,所以这里测的是预热后的查询,冷磁盘读取仍未测。
索引后的中位数更小,与扫描和排序减少的计划变化相符。这个结果只描述这组数据、参数和返回规模。更换客户分布、扩大结果集、改变排序,或让缓存放不下工作集,都可能改变收益。
体积也发生了变化:数据库从 32813056 字节增加到 38297600 字节,增加 5484544 字节,约 5.23 MiB。索引创建加提交这次花了 59.38 毫秒,不包括后续 ANALYZE。持续插入、更新和删除需要维护索引,本样例没有测量这些写入成本,也没有并发负载;上线前应把关键写入和其他常用查询纳入相同口径的验证。
在自己的机器上重跑
下载完整复现脚本,只需 Python 3 与其内置 sqlite3:
unzip sqlite-index-fixture.zip -d sqlite-index-fixture
cd sqlite-index-fixture
python3 reproduce.py results
脚本生成临时数据库,跑完后删除数据库,仅在 results 中保留 JSON。JSON 包含完整计划、每次耗时、参数、有序结果、环境和文件体积。重跑应先看结果是否一致与计划是否改变,再比较同机条件下的耗时;不同机器的毫秒数无需相同。
复现和解释所用的官方资料还有CREATE INDEX 语法。更多操作记录见工作流与方法。