Grok Voice 3.0 实时 API:固定版本与会话事件
将实时语音 WebSocket 客户端升级并固定到 grok-voice-3.0,掌握服务端与浏览器鉴权差异及核心会话事件流。
当你在代码中发起 wss://api.x.ai/v1/realtime 连接来驱动实时语音代理(Speech-to-speech)时,URL 查询参数里的 model 字段直接决定了底层响应的模型版本。根据 xAI 在 Grok Voice 3.0 发布说明 与 模型文档 中的记录,grok-voice-3.0 已于 2026 年 10 月 14 日正式上线,专用于实时语音代理的端到端语音交互(Speech-to-speech),这与纯文本生成、文生图或单向语音合成(TTS)及纯转录接口属于不同的任务链路。与此同时,旧版本 grok-voice-2.0 已被标记为弃用(deprecated)。
对于现有客户端,升级工作取决于你当初声明模型参数的方式。如果连接串使用的是动态别名 grok-voice-latest,Speech to Speech 文档 明确指出该别名目前已直接指向 grok-voice-3.0,客户端无需改动代码即已完成底层切换。但如果你的生产环境为了版本可控性将参数显式固定为了 grok-voice-2.0,或者你希望避免后续动态别名自动漂移带来的不确定性,现在就需要将连接参数显式修改并固定为 model=grok-voice-3.0。
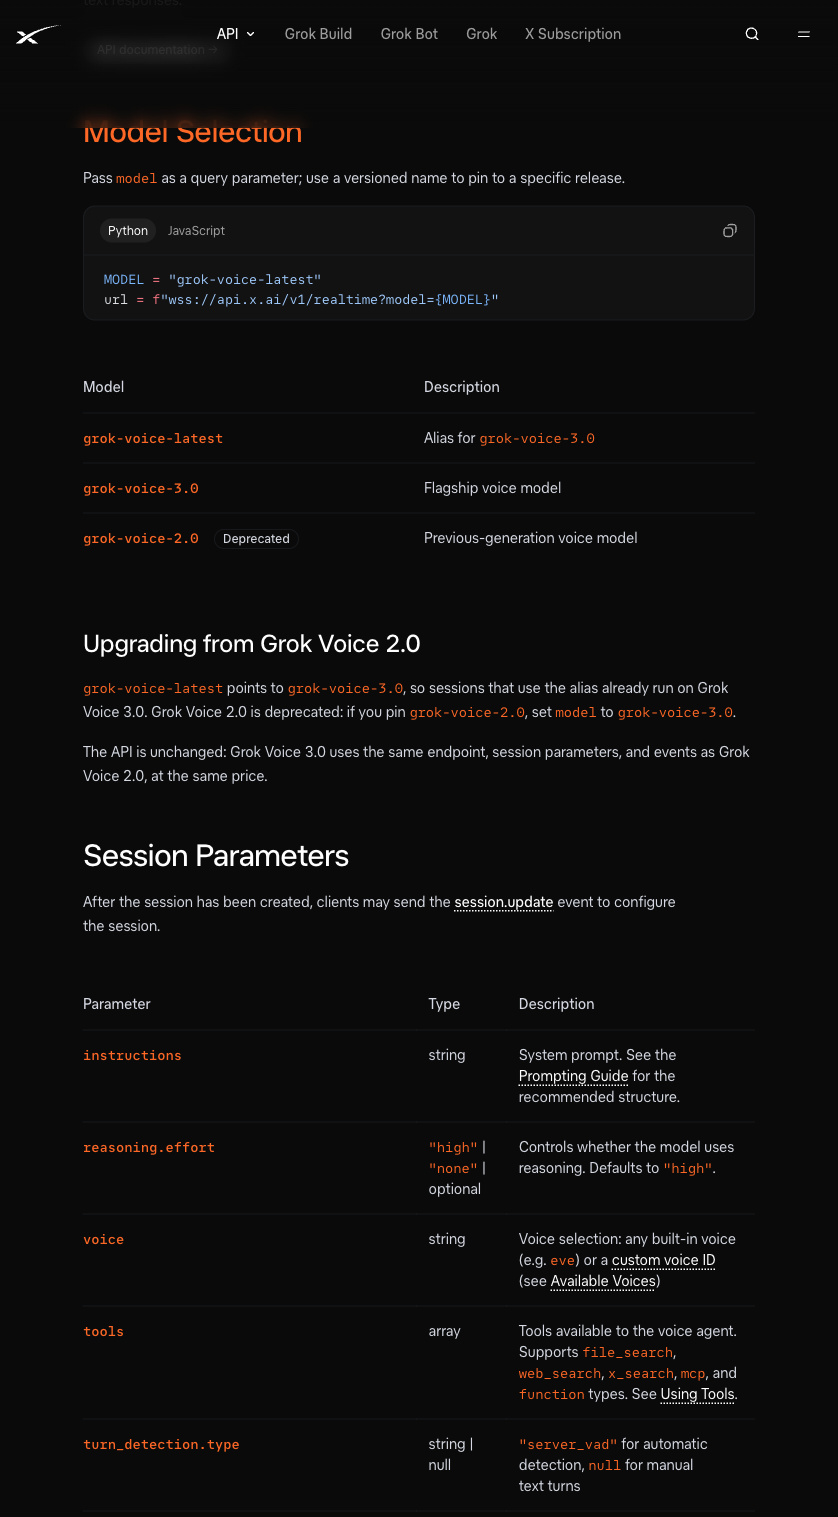
xAI 官方文档中的模型别名和 2.0 升级说明。
值得开发者注意的是,从 2.0 升级到 grok-voice-3.0 时,WebSocket 接入端点、会话配置参数以及客户端与服务端之间的事件名称(Session events)均保持不变。可以先保留原有事件处理,再在测试环境核对响应。在成本核算方面,官方公布 grok-voice-3.0 的上线定价与 2.0 保持一致,均为 $0.08/分钟(即 $4.80/小时)。在规划服务预算时,建议将单价与具体业务的计费时长计算规则分开核对,避免仅凭单价直接外推整套系统的总运营账单;本文核对的模型页未显示具体的速率限制,部署时应另查账户配额。
接入端点与客户端鉴权边界
实时语音会话通过 wss://api.x.ai/v1/realtime?model=grok-voice-3.0 建立长连接,但服务端环境与浏览器前端在鉴权实现上存在严格的边界。在 Node.js 或 Python 等受控服务端环境中,客户端可以在 WebSocket 握手阶段直接注入 HTTP 请求头,使用 Authorization: Bearer $XAI_API_KEY 完成身份验证。此时持久化的 API 密钥保存在服务端环境变量中,不会暴露给外部调用者。
如果语音交互直接从用户的浏览器发起,情况则有所不同。标准浏览器原生 WebSocket API 不支持由开发者自定义任意 HTTP 握手请求头,更关键的是,永远不能将持久化的主 API 密钥打包进前端代码或下发到客户端会话中(关于前端会话边界与敏感凭证隔离的更多工程实践,可参考站内文章 PWA 动态响应、CSP 与会话隐私)。针对浏览器端直连场景,官方文档要求先由你自己的后端向 xAI 申请短期有效的临时令牌(ephemeral token),前端拿到该临时凭证后,在实例化 WebSocket 时通过子协议字段 xai-client-secret.<token> 完成握手鉴权。
会话配置与文本触发音频事件流
连接建立后,客户端与服务端通过交换 JSON 事件帧来控制会话状态与媒体流。即便最终目标是全双工语音对话,在升级版本后的联调阶段,可以先“发送文本输入并接收音频输出流”,以此隔离麦克风采样与重采样带来的本地干扰。
整个交互按顺序由三个核心上行事件驱动:
- session.update:在连接打开后首先发送,用于初始化或修改当前会话参数。你可以在 session 对象中指定音色(例如 “voice”: “eve”)、系统提示词(instructions)以及语音活动检测模式(turn_detection)。其中 turn_detection.type 可设为 “server_vad”(由服务端自动检测说话停顿并触发响应)或设为 null(关闭自动检测,由客户端显式控制回合)。此外,模型支持调整推理深度参数 reasoning.effort,可选值为 “high” 或 “none”,默认状态下为 “high”。
- conversation.item.create:向当前对话上下文中追加一条用户消息。在下面的文档示例中,将 item.type 设为 “message”、role 设为 “user”,并在 content 数组中传入一个 type 为 “input_text” 的文本对象(例如 “Hello!”)。
- response.create:通知服务端立即根据当前上下文生成回复。服务端随后会持续下发事件流,其中包含生成的音频分片事件 response.output_audio.delta。
以下 JavaScript 示例改编自官方快速开始,仅将模型参数固定为 grok-voice-3.0。本文未发起付费调用,也未测试音频播放。代码只打印事件类型,不包含麦克风采集或扬声器播放。
import WebSocket from "ws";

const ws = new WebSocket("wss://api.x.ai/v1/realtime?model=grok-voice-3.0", {
  headers: { Authorization: `Bearer ${process.env.XAI_API_KEY}` },
});
ws.on("open", () => {
  ws.send(JSON.stringify({
    type: "session.update",
    session: { voice: "eve", instructions: "You are a helpful assistant.",
      turn_detection: { type: "server_vad" } }
  }));
  ws.send(JSON.stringify({
    type: "conversation.item.create",
    item: { type: "message", role: "user",
      content: [{ type: "input_text", text: "Hello!" }] }
  }));
  ws.send(JSON.stringify({ type: "response.create" }));
});
ws.on("message", (data) => {
  const event = JSON.parse(data);
  console.log("Event:", event.type);
});
要在本地运行上述脚本,你的账户需要具备有效的 xAI API 访问权限与可用余额,并在 Node.js 环境中安装 ws 库(若使用 Python 则对应 websockets 库)。
音频编码格式与传输检查
当控制台开始打印下行事件类型并捕获到 response.output_audio.delta 时,客户端需要按照会话约定的编码格式解码音频负载。如果不显式覆盖音频配置,Grok Voice 3.0 默认输出 24kHz 采样率的小端序 16 位线性 PCM(PCM16 little-endian at 24kHz)。
如果你的下端播放设备或电话网关对采样率与编码有特定要求,可以在会话配置中调整格式。根据官方文档说明,系统支持的编码与采样率组合如下:
| 编码格式 | 支持的采样率 (Hz) | 默认传输封装说明 |
|---|---|---|
| PCM (PCM16 little-endian) | 8000, 16000, 22050, 24000 (默认), 32000, 44100, 48000 | JSON 事件内默认使用 Base64 编码字符串 |
| PCMU / PCMA (G.711) | 8000 | JSON 事件内默认使用 Base64 编码字符串 |
| Opus | 24000 | JSON 事件内默认使用 Base64 编码字符串 |
在解析 response.output_audio.delta 事件时,需要特别检查负载的传输形态:在标准 JSON 事件流中,音频增量数据默认以 Base64 字符串的形式封装在事件字段内,解码后才是原始字节流(如小端序 PCM16 字节序列);而纯二进制帧传输(binary transport)属于另一套独立的传输配置,不能直接混用解析器(关于不同接口响应结构差异的排查思路,可延伸阅读 API 响应结构差异比对)。
在自己的测试环境中运行时,先确认 session.update 没有触发错误,再查看 response.create 之后是否收到 response.output_audio.delta。若使用默认 PCM16/JSON 传输,Base64 解码后的字节数应与 16 位采样对齐;这只是负载检查,播放还需使用相同采样率,并处理分片缓冲、取消和连接错误。