JSON 转 CSV:先选列,再决定哪些信息能保留
用嵌套记录、缺失值、数组和超出安全整数范围的 ID,实测本地 JSON 转 CSV 的列映射、公式保护与信息边界。
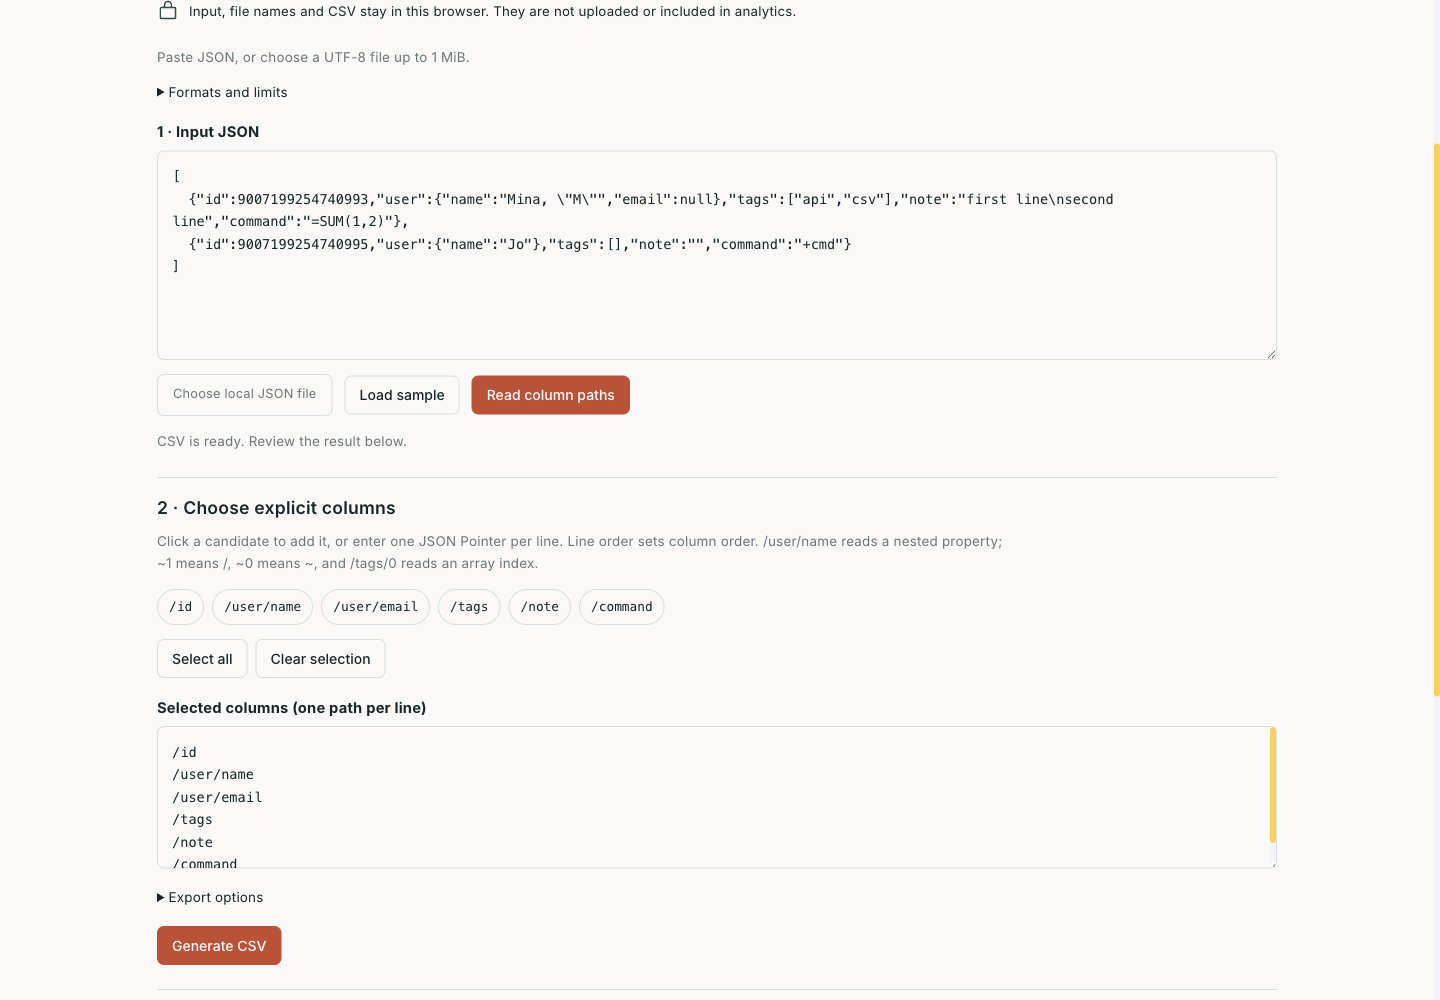
从 API 下载两条用户记录,交给同事做表格核对:ID 必须原样保留,姓名里带逗号,邮箱有时缺失,标签还是数组。这时把 JSON 的每个逗号换成分隔符很快就会失败。真正需要先决定的是:一行代表谁、哪些属性成为列、每种值进入单元格后还保留什么。
JSON 转 CSV 工具把这三个决定放在同一页:输入 JSON,显式选择列,再检查结果并下载。文件只在当前浏览器读取,输入、文件名和结果不上传。下面用工具自带的样例走一遍,同时解释大整数、缺失值和电子表格公式各自在哪一步出问题。
两条记录,六列,先确定输出形状
可以直接点击“载入样例”,或下载同一份 JSON 输入。样例是原创测试数据,没有真实用户信息:
[
  {"id":9007199254740993,"user":{"name":"Mina, \"M\"","email":null},"tags":["api","csv"],"note":"first line\nsecond line","command":"=SUM(1,2)"},
  {"id":9007199254740995,"user":{"name":"Jo"},"tags":[],"note":"","command":"+cmd"}
]
点击“读取列路径”后,工具给出候选属性。它不会直接把所有属性导出;点击需要的路径,或把下面六行贴进列输入框。行序就是 CSV 的列序,也可以使用“选择全部”后再删改。
/id
/user/name
/user/email
/tags
/note
/command
这份 列清单使用 JSON Pointer:/user/name 表示先找 user 再找 name。属性名本身含 / 时写成 ~1,含 ~ 时写成 ~0,因此键名 a/b 对应 /a~1b。需要数组第一项时,可以手动写 /tags/0;整个 /tags 则把数组留在一个格里,不会把一名用户展开成多行。
点击“生成 CSV”,默认输出 2 行、6 列、1 个缺失、1 个 null、1 个空字符串、2 个结构格、2 个已保护文本。这些计数帮助核对本次转换发生了什么:第一条记录的邮箱是 null,第二条没有邮箱属性;两个标签值都是数组;两条 command 文本触发了公式保护。
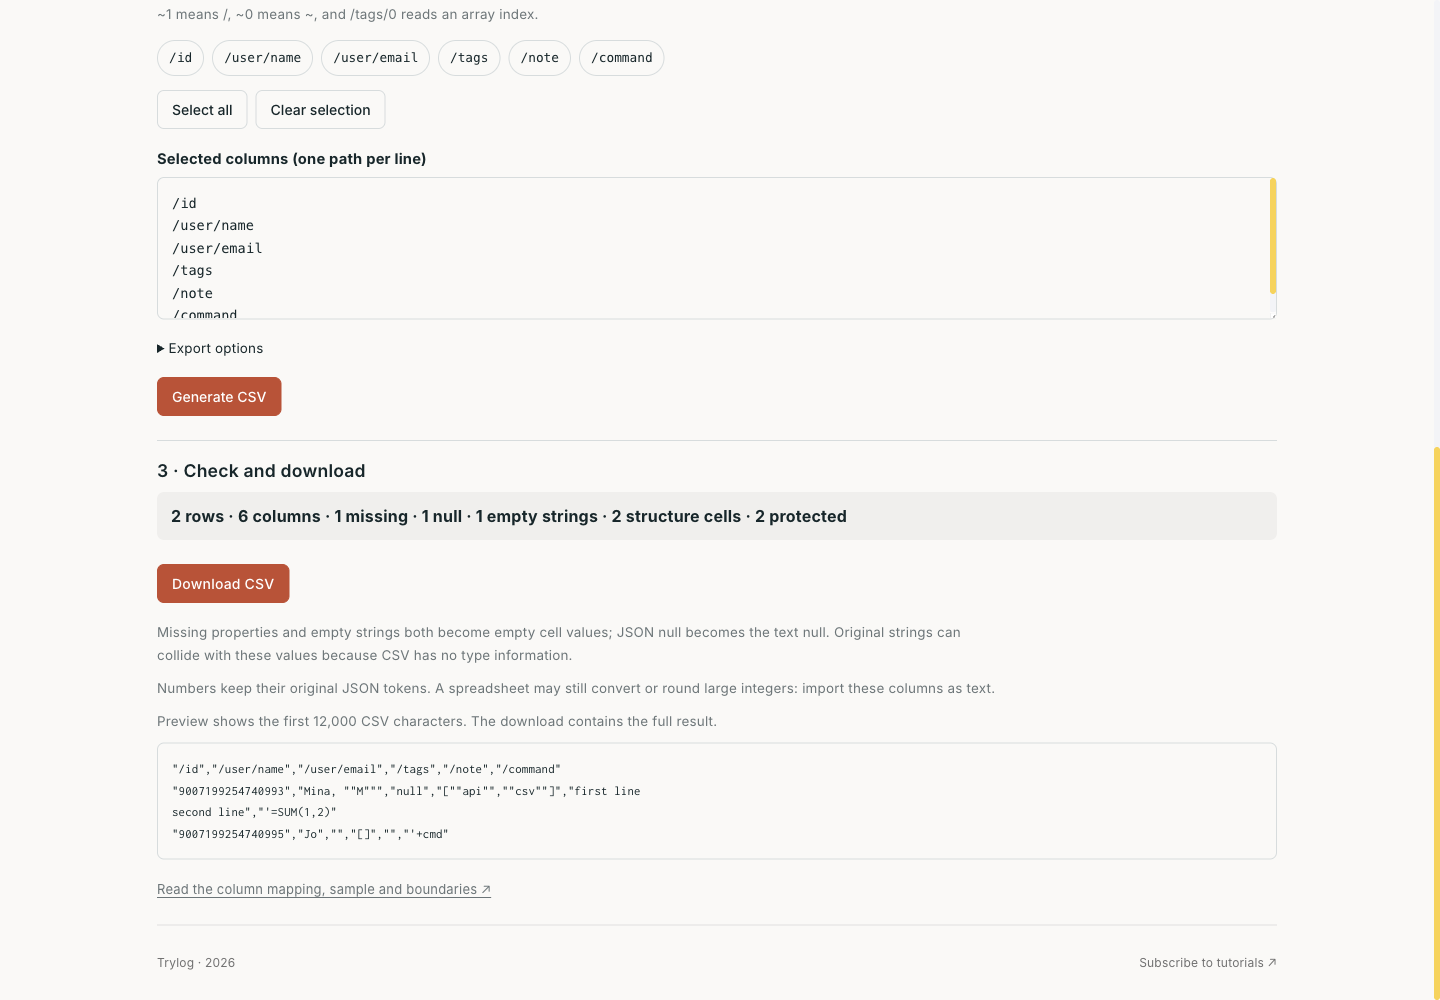
统计和预览来自同一次生成。修改后保留上次结果,并暂停下载,直到重新生成或恢复。
数值要在解析阶段保住
两个 ID 都超过 JavaScript 的最大安全整数 9007199254740991。先调用普通 JSON.parse() 再把 Number 转为字符串,原始十进制位数可能已经改变。给 CSV 加引号发生在解析之后,无法还原这一步丢失的精度。
当前实现使用 jsonc-parser 3.3.1 的语法树,并禁止注释、尾逗号和空输入。遇到数字节点时,只取它在原文中的位置与长度,保存原始 token;不消费节点里的 JavaScript Number 值。输出时再把该 token 写入 CSV。嵌套对象或数组转为格内 JSON 时,也经过同一套保留数值词面的序列化。
实际文件导入与下载保留了两个不同的 ID:9007199254740993 和 9007199254740995。另外一组输入中的 -0、1.2300e+04、1e9999、1e-9999 也按原文导出。这证明转换器保留了数字的文本表达;下载后用电子表格打开,软件仍可能自动转成数字、科学计数法或舍入值。要核对长 ID,应通过导入界面把该列指定为文本。
重复属性名在同一个对象里会被拒绝,包括 "a" 与 "\u0061" 这样解码后相同的键。否则“保留前一个还是后一个”会悄悄变成转换器的决定。实现还使用没有原型的对象保存属性,使 __proto__ 这样的原始键名可以作为普通数据处理。
空格值、null 和数组需要明确约定
CSV 只保存行、列和字段文本,没有 JSON 的类型信息。当前工具的处理规则是:
| JSON 中的情况 | CSV 字段值 | 这一步的代价 |
|---|---|---|
| 属性不存在 | 空文本 | 与空字符串相同;缺失计数单独保留在页面 |
空字符串 "" | 空文本 | 无法只靠 CSV 还原它原本存在 |
null | 文本 null | 与原本的字符串 "null" 相同 |
| 数字或布尔值 | 数值原始词面,或 true / false | CSV 下游仍需自己确定类型 |
| 数组或对象 | 紧凑 JSON 文本 | 结构保留在单个字段里,下游需再次解析 |
如果下游程序要求每格都是简单值,在“导出设置”里把数组与对象改为“遇到数组或对象就拒绝”。这时包含 /tags 的样例会报错;改用 /tags/0,或删去这一列后重试。工具不会推测需要多少行,也不会对不同数组做笛卡尔积。
这也解释了显式选列的作用。自动发现路径适合提醒你数据里有哪些字段,而真正的输出契约应由列清单决定。需要保留缺失与 null 的区别时,应先在源数据中添加存在性字段,或继续使用 JSON;一个 CSV 空格值承载不了所有原始状态。
正确的 CSV 引号与公式保护是两件事
所有字段都会加双引号,字段内的 " 写成 "",行与行之间使用 CRLF。姓名 Mina, "M" 因而仍是一个字段;note 中的换行保留在字段内部。下载包里的 实际默认输出已用独立 CSV 读取器核对,得到三行记录(含表头)、每行六个字段,逗号、引号和内部换行保持原值。
但 CSV 的双引号不阻止电子表格把 =SUM(1,2) 当成公式。默认保护会在以下文本前加单引号:去掉前导空白后以 =、+、-、@ 开始,或原文以制表符、回车、换行开始。样例中的两个 command 字段于是变成 '=SUM(1,2) 和 '+cmd。数字 token 不加这个前缀。
保护会改变字段值。给脚本继续处理、且明确知道下游不会执行公式时,可以主动选择“原文导出”;页面会明确显示风险。不同表格软件和再次保存后的行为还可能不同,导入不可信数据时仍应按文本处理。相关风险可继续阅读 OWASP CSV Injection。
出错后从哪一步继续
输入上限为 1 MiB 的 UTF-8 文本或文件,顶层必须是一个对象或非空对象数组。当前版本限制 10,000 行、128 个候选列、32 层容器、100,000 个节点和 8 MiB 输出。带 BOM 的 UTF-8 文件可以读取;输出 BOM 是单独可选项。JSON Lines、注释、尾逗号、同一对象内重复键和未配对 Unicode 代理项会被拒绝,属性名含换行也不支持。
这些限制让浏览器内的同步解析保持在有界工作量内。取消选文件、超限或非法文件都保留当前输入和结果。编辑内容、列路径或设置时,上一份结果仍显示,但会明确标示“上一次结果”并暂停下载;重新生成后才得到对应当前输入的 CSV。错误恢复保留自定义列顺序,也可以点击“恢复上次导出”恢复输入、列和选项。手机端在有结果后提供底部生成与查看结果入口。脚本未加载时,读取按钮保持禁用,页面保留明确提示。
对于这两条样例,完整可复现交付就是输入 JSON、六行列清单和下载后的 CSV。保留这三份文件,比只保存最终表格更容易排查:ID 的文本变了就查解析与表格导入,行数变了就查数组展开规则,某列突然空了就回到原始键名和列路径。