多尺度 WebGL 坐标精度:用真实绘制比较局部重基准与分层表示
用原创 64 点圆环与 6 万点样本,实测大坐标 float32 的绘制误差、CPU 局部重基准的边界和缓冲复用的帧表现,并提供 WebGL 2 复现代码与原始 CSV。
把一个半径 96 的圆环放到世界坐标 1e9 附近,再把相机移到圆心,应该仍然看到圆环。我的 WebGL 2 小实验里,直接上传全局 Float32Array 的版本却只剩几个方格点:原来的 64 个顶点在 GPU 中合并成 12 个不同位置,最大位置偏差为 78.81921 个绘图像素。
把减去局部原点的操作移到 CPU,并在转成 float32 之前完成,同一份样本恢复了 64 个位置,最大偏差降到 0.00000868 像素。这解决了这组坐标的精度问题。另一个固定 6 万点的测试则显示,复用缓冲能省去逐帧重建和上传的 CPU 工作,但这次浏览器的帧间隔没有稳定变好。两件事需要分别诊断。
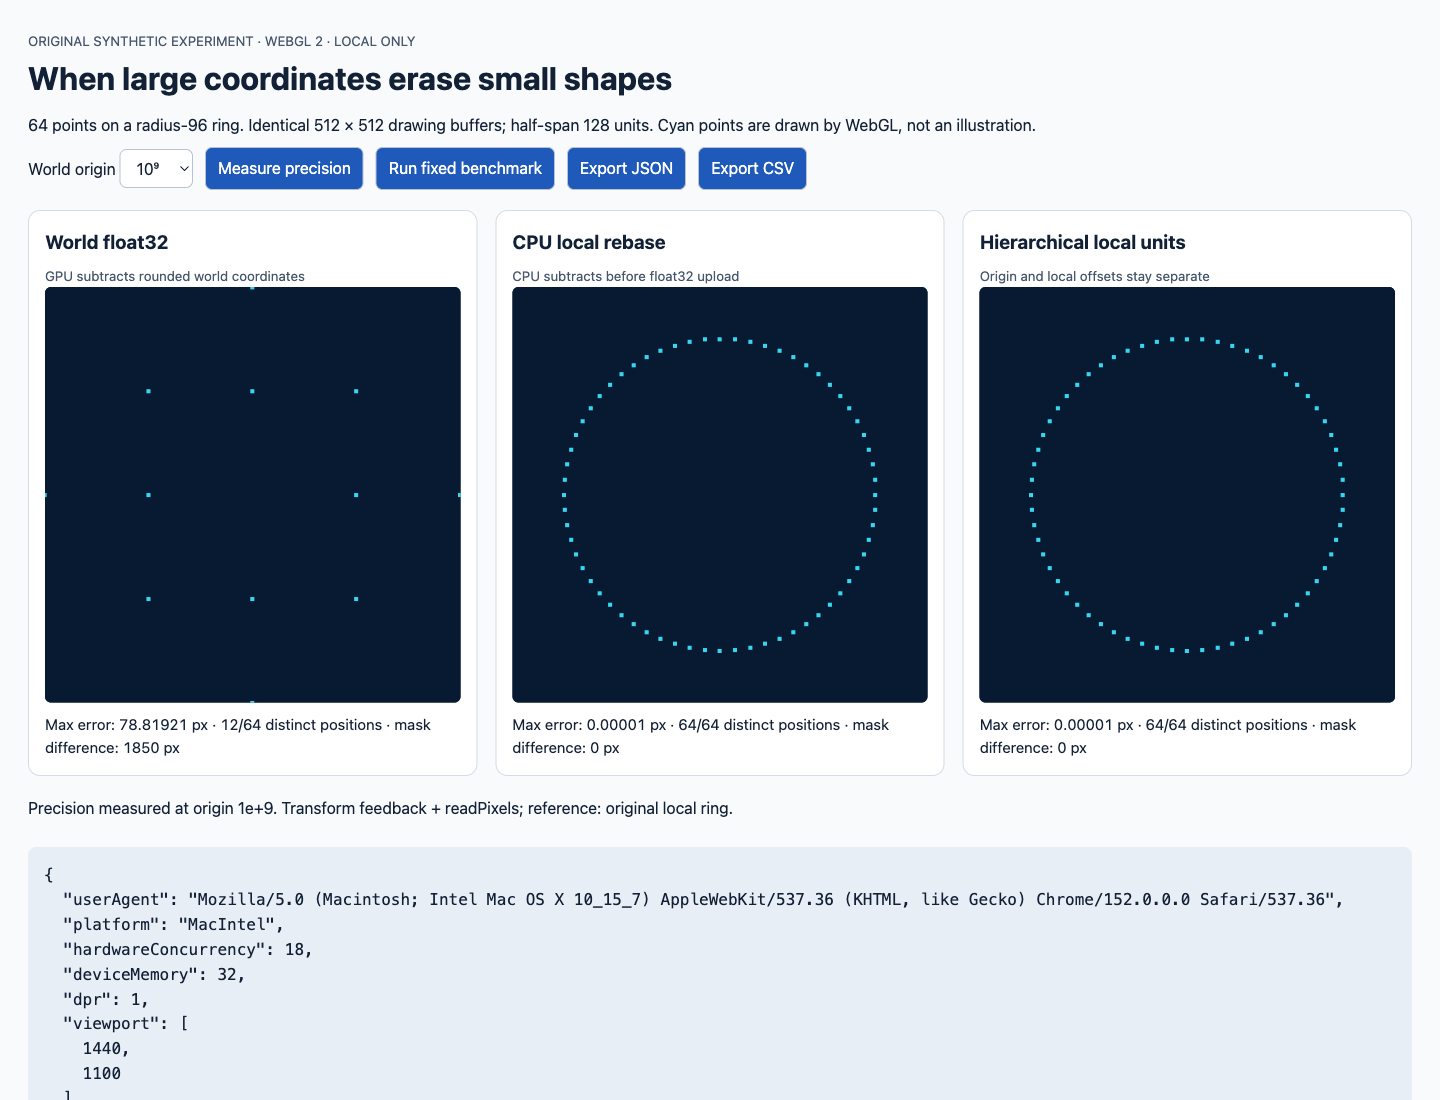
相同的 512 × 512 绘图缓冲,世界原点为 10⁹。青色点由 WebGL 实际绘制。
这篇笔记面向做地图、CAD 或跨尺度可视化的开发者,帮助定位“大坐标里的小几何为什么抖动、合并,以及修正之后为什么仍可能卡顿”。选题来自一则从地球向外缩放的 WebGL 展示讨论。原作者报告了移动端性能困扰;下面的代码、几何和测量均为独立制作的合成实验,未使用原项目或天文目录。
固定一个能看清误差的样本
圆环包含 64 个点,局部位置为:
const angle = 2 * Math.PI * i / 64;
const local = [96 * Math.cos(angle), 96 * Math.sin(angle)];
const world = [origin + local[0], origin + local[1]];
原点的 x、y 相同,依次取 1e3、1e6、1e9、1e12、1e20。相机始终看向该原点,视口半跨度为 128 单位,圆环的参考屏幕半径是 192 像素。每个 Canvas 的绘图缓冲固定为 512 × 512,点大小为 5,关闭抗锯齿;CSS 缩放不参与误差单位。
环境为 Apple M5 Max、128 GiB 物理内存、macOS 27.0,Ego Lite 中的 Chromium 152,渲染器报告 ANGLE Metal Renderer: Apple M5 Max。桌面测试视口是 1440 × 1100,测试 DPR 设为 1。浏览器的 deviceMemory 返回 32,它是浏览器报告值,与装机内存分别记录。顶点着色器的 HIGH_FLOAT 查询得到 rangeMin=127、rangeMax=127、precision=23。
实际设备精度应调用 getShaderPrecisionFormat 查询。这里的 highp 声明保留着色器可用精度,而数据进入缓冲时已经发生的舍入仍会保留。
在哪一步减去原点,决定保留下来的信息
三条路径使用同一个顶点着色器,输入和 uniform 不同:
#version 300 es
precision highp float;
in vec2 a_position;
uniform vec2 u_origin;
uniform float u_halfspan;
out vec2 v_clip;
void main() {
  v_clip = (a_position - u_origin) / u_halfspan;
  gl_Position = vec4(v_clip, 0.0, 1.0);
  gl_PointSize = 5.0;
}
全局 float32 路径先把 origin + local 写入 Float32Array,GPU 再减 uniform 原点。CPU 重基准路径则在 JavaScript Number 中算 world - origin,之后转 float32;GPU 原点设为零。分层局部路径保留独立锚点和局部偏移,本样本直接上传 local / 128,GPU 原点为零、半跨度为 1。
可以看圆环第二个顶点的 x 分量:局部参考值约为 95.5377337605。在 1e9 附近,全局 float32 上传的是 1000000064,GPU 减完原点得到 64;CPU 重基准上传约 95.5377349854;分层路径上传约 0.7463885546。误差的位置在缓冲进入 GPU 之前已经分明。
二进制 float32 的有效位数为 24 位,在正常数区间 [2^e, 2^(e+1)) 中,相邻值间距为 2^(e-23)。1e9 位于 2^29 与 2^30 之间,间距是 64。96 单位的圆环放进去,若干顶点自然会落到同一格;换一种投影矩阵也无法恢复已合并的坐标。
用 GPU 输出和像素同时核对
我在链接程序前用 transformFeedbackVaryings 登记 v_clip,实际执行顶点着色器后,通过 getBufferSubData 读回 64 个裁剪空间位置。这条路径是 WebGL 2 规范 的 transform feedback 功能。每个点的误差按下面的方式计算:
const dx = (gpuClipX - localX / 128) * 256;
const dy = (gpuClipY - localY / 128) * 256;
const errorPixels = Math.hypot(dx, dy);
随后关闭 RASTERIZER_DISCARD,真正绘制点,再用 readPixels 读回颜色。青色点的二值掩膜与分层局部路径做逐像素比较。这个掩膜指标说明最终哪些像素发生变化;顶点最大误差则保留亚像素差别。
| 世界原点 | 全局 float32 最大偏差 / px | CPU 重基准最大偏差 / px | 分层局部最大偏差 / px |
|---|---|---|---|
| 10³ | 0.00016023 | 0.00000868 | 0.00000868 |
| 10⁶ | 0.07454506 | 0.00000868 | 0.00000868 |
| 10⁹ | 78.81921478 | 0.00000868 | 0.00000868 |
| 10¹² | 192.00000000 | 0.00016023 | 0.00000868 |
| 10²⁰ | 192.00000000 | 192.00000000 | 0.00000868 |
在 1e9,全局路径与参考掩膜相差 1,850 个像素,CPU 重基准路径相差 0。原点到 1e12 后,全局路径所有点合并为一个位置,CPU 路径仍有 64 个位置。1e6 的全局路径虽然有约 0.075 像素偏差,本次掩膜仍相同;像素结果取决于点是否越过栅格边界。因此“截图看着一样”并不意味着坐标误差是零。
精度读回会同步 GPU/CPU 工作,适合单独诊断。帧表现测试期间没有执行 transform feedback 读回或 readPixels。
先拼成 10²⁰,再重基准也会太晚
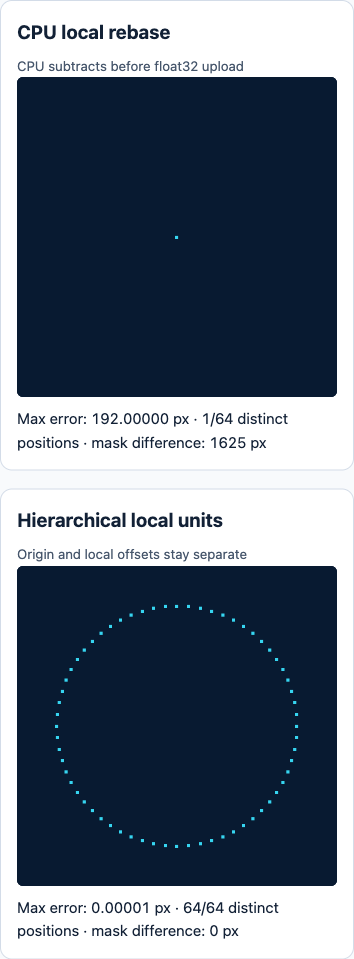
原点到 10²⁰ 时,CPU 重基准也出现 192 像素最大偏差。
JavaScript Number 使用 IEEE 754 binary64。1e20 附近的 binary64 间距是 16,384,远大于半径 96。执行 world = 1e20 + local 时,细节就已经消失:本实验的 world - 1e20 全部为零。之后转 float32、切换 highp 都只能传递这个零。
如果数据的范围需要跨越许多数量级,应该在数据模型中保留层级关系。例如让一个大尺度锚点记录所属分支,子层用自己的单位保存小几何:
const layer = {
  anchor: { id: "synthetic-root", origin: "1e20" },
  halfspan: 128,
  positionsLocal: localCoordinates  // Float64Array, roughly -96..96
};
const gpu = Float32Array.from(layer.positionsLocal,
  value => value / layer.halfspan);
这里把巨大原点写为字符串,是为了保存场景标签;渲染当前分支时没有把它解析后加回每个顶点。实验中的相机与对象共享锚点,局部相机偏移为零。这是一个分支的局部表示验证。多个相距很远的分支、父子变换的累计误差和连续跨层插值需要自己的注册与过渡测试。
实际跨层实现可以先在同一父层单位中求 (对象偏移 - 相机偏移),再把子层的局部值按尺度比投影。只在数值量级可控的公共坐标系里运算,避免在叶子顶点上反复构建巨大全局位置。下载包的 layer-sample.json 保留锚点、局部单位、参考几何和三个路径的中间输入,便于检查这条边界。
修正坐标后,单独测缓冲与帧表现
性能样本是同一生成器产生的 60,000 个二维点,分布在半径 96 范围内。缓冲为两个 float32 分量,共 480,000 字节。每种策略预热 30 帧,再记录 120 帧;做两轮,第二轮倒序执行,以减少固定顺序的影响。Canvas 绘图缓冲、着色器、点大小和相机参数保持一致。
比较的策略包括全局缓冲复用、CPU 每帧重基准并 bufferSubData、CPU 一次重基准后复用、局部层缓冲复用,以及局部层只绘制前 6,000 个点。最后一项是明确减小点数的负荷实验;它改变显示内容,不能当作相同画质的自动优化。它仍分配完整 480 KB 缓冲,测的是少画点,不是内存节省。全局 float32 行的画面本身已经失真,其性能只作错误基线;缓冲重建与复用的比较应看两条 CPU 重基准路径。
用 performance.now() 包围“可选的坐标重建和上传、清屏、drawArrays、flush”,记为 CPU 提交耗时。同时记录相邻 requestAnimationFrame 回调的时间戳差,记为帧间隔。下面数字均为毫秒,p95 使用排序后第 ceil(0.95 × n) 个值。
| 策略 | CPU 提交中位数:第 1 / 2 轮 | CPU 提交 p95:第 1 / 2 轮 | rAF 中位数:第 1 / 2 轮 | rAF p95:第 1 / 2 轮 |
|---|---|---|---|---|
| 全局 float32,复用,6 万点 | < 0.1 / < 0.1 | 0.1 / 0.1 | 16.7 / 16.7 | 33.4 / 33.3 |
| CPU 重基准,逐帧重建,6 万点 | 0.4 / 0.3 | 0.7 / 0.5 | 16.7 / 16.7 | 33.4 / 33.4 |
| CPU 重基准,复用,6 万点 | < 0.1 / < 0.1 | 0.1 / 0.1 | 16.7 / 16.7 | 33.4 / 33.3 |
| 局部层,复用,6 万点 | < 0.1 / < 0.1 | 0.1 / 0.1 | 16.7 / 16.8 | 33.4 / 33.4 |
| 局部层,少画到 6 千点 | < 0.1 / < 0.1 | 0.1 / 0.1 | 16.7 / 33.3 | 33.3 / 33.4 |
原始 CPU 中位数中有多处 0,浏览器计时表现为约 0.1 ms 的量化台阶。表中写 < 0.1 表示低于本次有效计时分辨率。逐帧重建确实额外分配坐标数组,并每帧上传 480 KB;这里观察到更多 CPU 工作。帧间隔没有形成稳定的策略差别,少画点的第二轮中位数反而升到 33.3 ms。
测试在桌面浏览器会话中运行,标签保持 visible,未隔离其他系统或浏览器活动。这些数据支持“当前样本减少了提交工作”的结论,尚不足以定位帧间隔尾部波动的原因,也没有证明某种策略能改善旧手机帧率。
requestAnimationFrame 提供浏览器刷新调度的时间戳。flush 提交命令后无需等 GPU 完成,所以上述两个时间指标都应保持自己的名称。这个环境存在 EXT_disjoint_timer_query_webgl2,本实验没有使用它;若下一步要量 GPU 执行时间,需要异步取 query 结果并检查 disjoint 状态。
把精度预算与层级切换接起来
对正常 float32 坐标,先估算局部坐标量级的 ULP,再乘“每世界单位对应的绘图像素”。例如本实验每单位对应 2 像素,全局原点处 ULP 为 64,误差已经足以跨过许多像素。局部值约为 100 时,float32 ULP 约 7.6e-6 单位,小得多。这个预算能帮助选择 tile、锚点和局部单位;最后仍应读回实际着色器结果,尤其是在投影包含额外变换时。
缓冲已经是对象相对锚点的局部位置时,相机的小幅移动通常可用小范围 uniform 处理。对象几何变化、换锚点或加载新层时再更新相应缓冲,可以把每帧重建改成事件驱动。单纯在 shader 中从全局 float32 再减一个原点,会保留已经量化的形状。
如果缩远后许多点挤到同一像素,可以另做粗层样本和屏幕误差验收。精细层与粗层应在同一相机和像素单位下对齐,并给切换阈值留迟滞区间,避免阈值附近来回跳。这里的 6 千点测试只测了绘制数量变化;代表点选择、切层连续性和画质容差需要结合实际内容设计。
下载并重跑
下载原创最小项目与原始测量 ZIP,其中包含 index.html、lab.js、MIT 许可、层级样本、桌面 JSON 与 1,200 行逐帧 CSV。代码无需外部依赖,没有上传逻辑。
解压后,在该目录启动一个本地静态服务器:
python3 -m http.server 4343 --bind 127.0.0.1打开 http://127.0.0.1:4343,先选择 10⁹ 和 10²⁰ 看圆环,再点击 Run fixed benchmark。保持标签前台,等待完成后导出 JSON 和 CSV;换硬件时保留浏览器版本、renderer、视口、绘图缓冲、点数和原始帧数据,便于在同一口径下比较。本文还检查了桌面浏览器 390 × 844 窄视口下的页面和绘制,绘图缓冲仍为 512 × 512;这项检查覆盖的是布局和同一桌面 GPU。
这组实验给出的起点很具体:先确认坐标在上传前是否已经合并;能在 binary64 中保留差值时,CPU 重基准足够简单;差值在拼全局坐标时就消失,则从数据模型保留局部层级。坐标恢复后,再用独立的提交与帧测量决定下一步优化位置。