读懂 Artificial Analysis Intelligence Index:速度、缓存与每任务成本
核对 Intelligence Index v4.3.2 的评测权重、速度和成本口径,用可运行的合成账本计算缓存、推理 token、失败重试及每次成功成本。
假设你要给一个开发工具接入模型:输入一段构建日志,返回符合 JSON Schema 的错误分类、证据行和下一步命令。候选模型在榜单上分别领先能力、速度和成本,该选谁?先把成功条件写下来:JSON 能解析、分类有依据、命令适用于当前环境;再看等待时间和完成这件事花多少钱。榜单可以缩小候选范围,最后一轮选择需要自己的日志样本。
本文核对 Artificial Analysis Intelligence Index 的组合与计费口径,并用一份可运行的合成账本演示缓存、推理 token 和失败重试。方法页核验日期为 2026-10-06,当时版本是 v4.3.2。所有手算费率与任务结果均为人为设定,文章未调用模型 API。
先分清首页的三个数
Artificial Analysis 首页把 Intelligence、Speed、Cost per Task 放在一起。阅读时保留完整模型配置,例如括号内的 reasoning effort、是否带 fallback,以及对应的 API 提供方。相同模型换推理档位或端点,表现和账单都会变化。
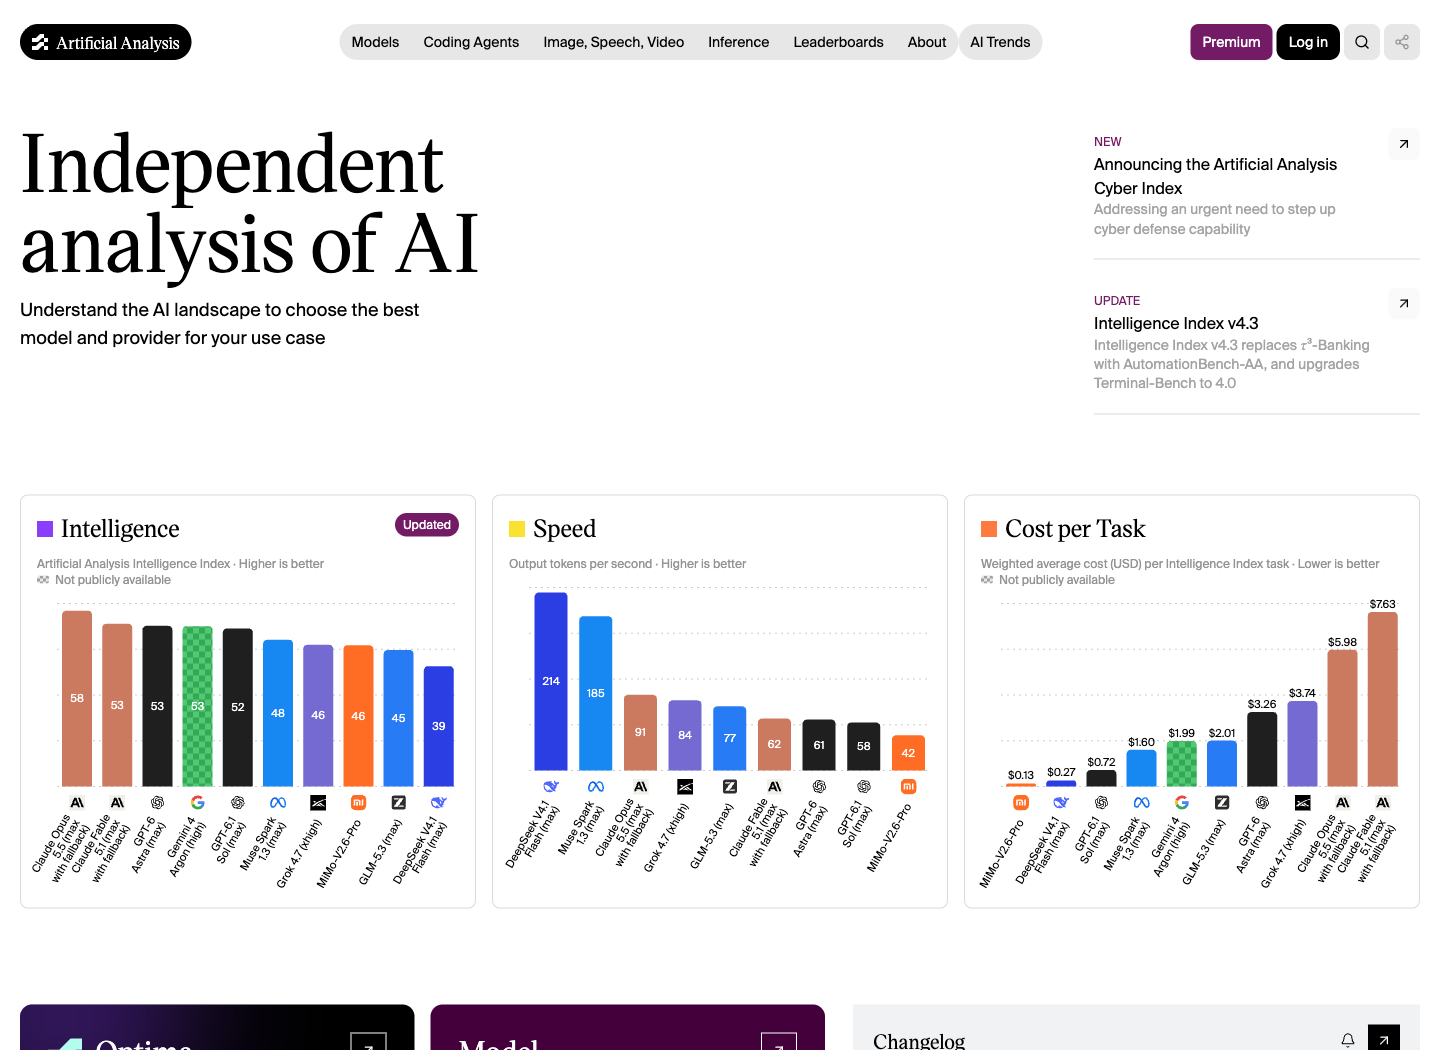
Artificial Analysis 首页的能力、速度与每任务成本图。来源:官网,可打开原尺寸截图查看图内文字。
| 指标 | 它回答的问题 | 选模型时接着核对什么 |
|---|---|---|
| Intelligence Index | 在指定评测组合中,模型总体得分如何? | 哪些子评测接近自己的工作;语言、工具与成功条件是否匹配 |
| Speed | 首个 token 到达后,输出生成有多快? | 第一个可见答案何时出现,完整任务耗时及较慢请求的延迟 |
| Cost per Task | 按 Index 权重,一项评测任务平均消耗多少 API 美元? | 自己的输入、缓存、推理、重试及成功率 |
这三项可以一起筛选。例如后台日志分类容许稍长等待,却要求格式可靠;交互式补全则可能先设严格的首答案延迟门槛。先写约束,再在满足约束的候选中比较费用,选择过程就容易复查。
Intelligence Index v4.3.2 怎样组合
官方 Intelligence Benchmarking 方法页列出 10 项评测,按四类能力加权。下面百分比都是占整个 Index的权重,合计 100%。
| 类别与总权重 | 评测 | Index 权重 | 主要任务 |
|---|---|---|---|
| Agents 30% | AA-Briefcase v1.1 | 15% | 产出文件的长期知识工作任务 |
| Agents 30% | GDPval-AA v2.1 | 10% | 多职业的实际工作交付 |
| Agents 30% | AutomationBench-AA | 5% | 使用 REST API 工具完成 SaaS 工作流 |
| Coding 20% | Terminal-Bench 4.0 | 10% | 终端中的任务执行与测试 |
| Coding 20% | SciCode | 10% | 科学计算相关 Python 子问题 |
| Scientific Reasoning 20% | Humanity’s Last Exam | 10% | 高难度知识与推理 |
| Scientific Reasoning 20% | CritPt | 10% | 物理研究问题 |
| General 30% | AA-Omniscience | 15% | 准确率 10%+非幻觉率 5% |
| General 30% | GDP.pdf | 10% | 长 PDF 中的专业文档推理 |
| General 30% | AA-LCR v1.1 | 5% | 长上下文推理 |
AA-Omniscience 是一项评测,但为 Index 提供两个分量,因此有 10 项评测、11 个加权分量。它自己的 AA-Omniscience Index 与这里的两个分量也应分别读取。
各项原始成绩的尺度不同。终端评测可以按测试通过情况计分,工作交付则使用 Elo;官方把 AA-Briefcase 与 GDPval-AA 的 Elo 在模型加入时冻结,用 clamp((Elo - 500) / 2000) 归一化,再纳入组合。直接把原始 Elo 与另一项正确率相加会改变原有口径。综合 Index 分数也不能直接读作“我的任务成功百分比”。
版本变化会改变可比条件。官方版本历史写明:v4.3 用 AutomationBench-AA 替换 τ³-Banking,并将终端评测升级为 Terminal-Bench 4.0;v4.3.2 更新 GDPval-AA v2.1 与 AA-Briefcase v1.1 的 Elo 拟合。保存榜单时同时记录方法版本,跨版本变化应先看组成和评分规则,再判断模型是否进步。
对开头的日志分类任务,长文档推理、知识可靠性和格式成功率可能更相关;大规模终端代理能力只能提供部分线索。这个 Index 主要测英语文本,官方把图像、语音和多语言另列评测。中文日志、仓库术语和自定义 Schema 都需要加入自己的样本。
评测表中的 repeats 也有特定含义。官方通常以 pass@1 汇总多次独立运行的结果;多次 repeats 并不自动构成“失败后修正提示词再重试”的产品流程。重试允许几轮、能否看见上轮错误,应该在自己的协议中写清楚。
Speed 要和首答案、完整耗时一起读
官网通用方法页把 Output Speed 定义为:首个 token 到达后,后续输出 token 数除以输出时间;公式会扣掉第一块 token。性能比较采用 o200k_base tokenizer 统一计数,因此速度单位与供应商收费的原生 token 数应分开使用。
需要关注的等待时间有三种:
- Time to First Token:从发送请求到首个响应 token;返回推理 token 的模型可能先返回推理。
- Time to First Answer Token:等输入处理和思考结束,直到真正的答案开始。
- End-to-End Response Time:从请求到完整响应,包含输入处理、推理与回答生成。官网展示的这一指标以平均推理量加上 500 个回答 token 建模,自己的任务应计实际完整耗时。
用一个独立的合成时间例子感受差别:模型 A 首答案等待 4 秒,回答速度 100 token/s;模型 B 等待 0.5 秒,回答速度 50 token/s。若后续答案恰好 100 token,忽略分块等额外开销,A 约需 4 + 100 / 100 = 5 秒,B 约需 0.5 + 100 / 50 = 2.5 秒。若答案是 1,000 token,则分别约 14 秒和 20.5 秒。回答长度改变了更快完成的候选。
代理任务还有工具调用、网络、沙箱和多轮输入。官网的 Time per Intelligence Index Task 标为加权 decode 时间,排除 TTFT 和额外开销;为工具设置超时预算时,记录完整任务的 p50、p95 以及是否超时会更贴近用户体验。
Cost per Task 的权重与美元从哪里来
官网用输入、缓存和输出 token 的实际消耗乘对应费率,先得到每项评测的平均任务成本,再按与 Intelligence Index 相同的评测权重合成:
Cost per Task = Σ [评测权重 × (该评测总 token 费用 / 该评测任务数)]因此题数最多的评测不会仅凭题多占据最高权重。看一个独立的玩具评测组合:X 有 2 个任务、总费用 $0.40、权重 25%;Y 有 8 个任务、总费用 $0.40、权重 75%。加权结果是 0.25 × 0.40 / 2 + 0.75 × 0.40 / 8 = $0.0875。直接把所有费用除以 10 个任务得到 $0.08,采用的是另一种任务分布。这里的权重只用于说明算法。
官方费用采用模型 API 提供方报告的 token 数;少数缺失情形使用标准 tokenizer 兜底。费率来自第一方 API,或各提供方的中位数;缓存成本随提供方变化,展示缓存率和费用时结合近期实测的代表性缓存命中率。它与一份旧评测运行当时的单次缓存记录可能不同。
另一个容易混淆的指标是 Blended Price。当前通用方法页按 cache hit、input、output 为 7:2:1 混合费率:(7 × 缓存命中价 + 2 × 输入价 + 输出价) / 10。这是固定比例的价格比较;Cost per Task 则随模型实际生成长度和推理量变化。两者各自计算,不要把固定混合比例再次套进任务账本。
把一次任务写成互斥的 token 账本
以下是合成算例,全部费率与 token 数均为人为设定,不对应任何真实模型或现价。设每百万原生 token:普通输入 $2,缓存写入 $2.50,缓存命中 $0.20,推理与回答均按输出 $8 收费。本例的缓存写入费替代普通输入费;真实服务的写入附加费、缓存保存费和长上下文费率需要按其价表调整。
一项日志分析任务收到 12,000 个输入 token,其中 10,000 个是可复用上下文,2,000 个是本轮日志。第一轮写入缓存,推理 1,500 token、回答 500 token;结果未通过 Schema 校验。第二轮重新请求,假定 10,000 个上下文全部缓存命中,仍有 2,000 个新输入,推理 1,000 token、回答 600 token,校验通过。
| 互斥计费项 | 第一次:失败 | 第二次:通过 | 美元/百万 token |
|---|---|---|---|
| 普通输入 | 2,000 | 2,000 | $2 |
| 缓存写入 | 10,000 | 0 | $2.50 |
| 缓存命中 | 0 | 10,000 | $0.20 |
| 推理输出 | 1,500 | 1,000 | $8 |
| 回答输出 | 500 | 600 | $8 |
第一轮:
(2,000 × 2 + 10,000 × 2.50 + (1,500 + 500) × 8) / 1,000,000
= $0.045
第二轮:
(2,000 × 2 + 10,000 × 0.20 + (1,000 + 600) × 8) / 1,000,000
= $0.0188
同一任务累计费用为 $0.0638。这里假定失败首轮完整计费;真实 API 报错是否计费须查供应商规则和 usage,不能只按状态码推断。
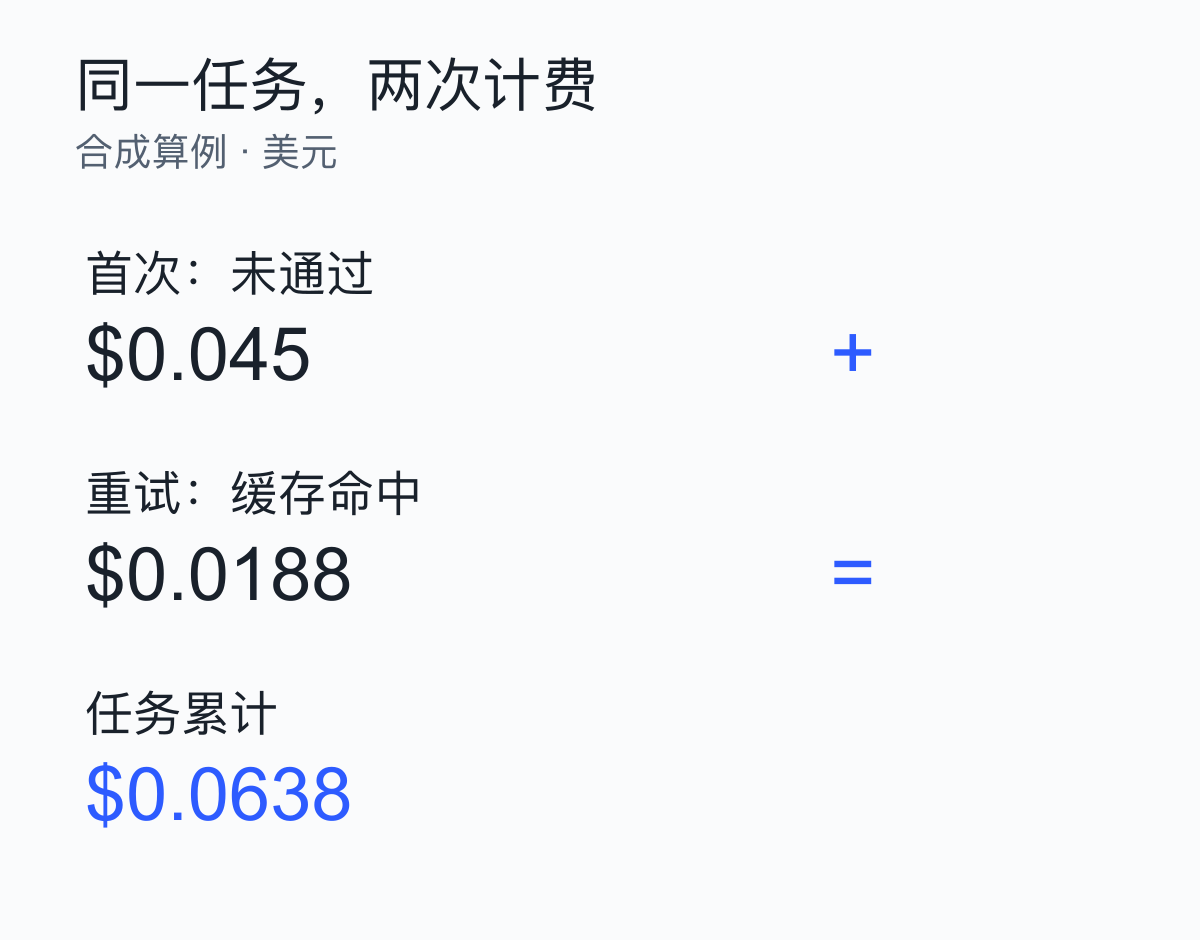
同一个任务的两次请求,分别计费后相加。
核对 usage 时,先判断字段是否包含子集。若 output_total=2,000 已包含 reasoning=1,500,回答就是 500,不能再算 2,000 + 1,500。输入同样要满足 total_input = 普通输入 + 缓存写入 + 缓存命中;供应商若在总输入中包含缓存命中数,要先减出普通部分。本例五个桶互不重叠,只收费一次。
缓存命中也是条件:重试换了系统提示词、超过有效期或不满足缓存前缀规则时,账本可能再次出现写入或普通输入。样本中的 100% 可缓存 token 命中是为方便手算设定的。
把“每次提交”与“每次成功”记在选择表里
沿用上述单轮费用,假设 10 项不同任务中 8 项首轮通过、2 项按示例重试后通过。总费用为 8 × 0.045 + 2 × 0.0638 = $0.4876,平均每项提交、每项成功均为 $0.04876;实际 API 请求数是 12 次。
再看另一个独立场景:10 项都只执行首轮,8 项通过、2 项失败。总费用是 $0.45,每项提交 $0.045,每项成功则为 $0.45 / 8 = $0.05625。同一费用分母改变后,回答的是不同问题。重试是否值得,还要看失败任务有多重要、额外等待和人工复核时间。
可以下载脚本、CSV 账本和选择表模板,解压后运行 python3 calculate.py。脚本仅用 Python 标准库,不联网,输出 attempts.csv 与 results.json;上述成本与两种均价都带断言。
给开头的日志工具做选择时,我会用下面这张检查表组织下一轮测试。门槛是示例需求,应随产品修改;真实候选结果留待实际运行填写。
| 选择项 | 示例约束与记录方式 | 对决定的作用 |
|---|---|---|
| 任务与样本 | 固定 20 份脱敏日志,含构建、依赖、权限错误和信息不足;记录样本版本 | 每个候选面对相同输入 |
| 成功条件 | JSON 符合 Schema;错误分类与证据行匹配;建议命令可用;信息不足时明确指出 | 先确定可接受输出 |
| 硬约束 | 当前示例要求至少 18/20 首轮通过,完整任务 p95 ≤ 8 秒 | 未达到门槛的候选不进入费用比较 |
| 账单 | 固定模型版本、端点、推理档位、提示词;列五类 token 与允许的重试 | 找出费用来自哪里 |
| 预算 | 示例上限为每项成功 $0.06;记总费用/提交数与总费用/成功数 | 与真实成功交付对应 |
| 恢复与人工 | 单列失败、取消、超时、复核分钟数与外部工具费 | 决定重试、降档或人工处理 |
20 个样本适合发现格式错误和明显差异;若候选只差一两个成功任务,扩充代表性样本并检查波动,再锁定配置。公开榜单可从 Model Recommender 继续缩小范围;需要比较多轮编码代理与路由时,可接着读编码代理路由的质量、费用与耗时。保留下来的选择表应能回答:这个配置在这批任务上达到了哪些约束,用了多少次请求,交付一个合格结果花了多少。