DeepSeek Flash API 迁移:模型别名、思考模式与工具调用
指导开发者将现有 OpenAI 兼容客户端平滑切换至指向 DeepSeek-V4.1-Flash-1017 的 deepseek-flash 模型别名,并正确处理思考模式下的输出上限、温度失效及工具调用限制。
DeepSeek 在 2026 年 10 月 17 日发布了 DeepSeek-V4.1-Flash-1017。官方模型表规定,对话接口的 model 字段使用 deepseek-flash,该别名目前映射到这个版本。迁移已有的 OpenAI 兼容客户端时,先核对模型字段,再处理默认开启的思考模式、输出预算和工具选择限制。
本文依据官方文档整理请求配置,未发起模型付费调用或性能实测。
模型别名映射与基础接口配置
在服务端配置中,首先需要校准请求端点与模型标识符的对应关系。根据 DeepSeek 官方定价与模型说明文档,调用当前 Flash 模型时,应传入 deepseek-flash 作为 model 字段值,服务端会自动将其路由至 DeepSeek-V4.1-Flash-1017。基础请求地址保持为 https://api.deepseek.com,对话补全路径依然遵循 OpenAI 兼容格式的 POST /chat/completions。要实际发起调用,你需要准备一个已充值且具备可用额度的 DeepSeek API 账户与密钥,并将其保存在服务端的环境变量中,避免硬编码在客户端仓库里。
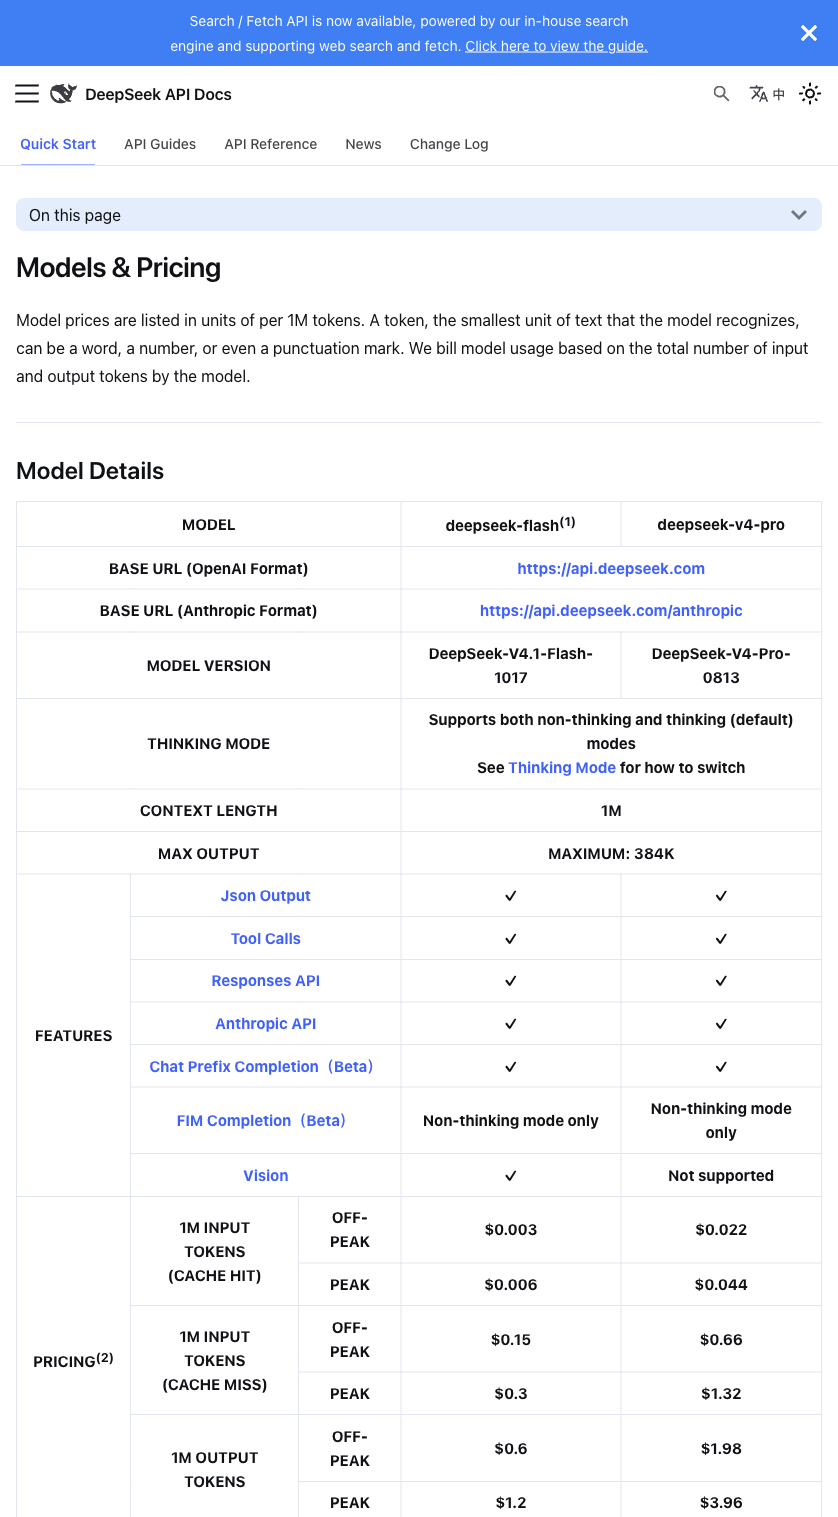
DeepSeek 官方模型表中的别名、上下文与输出上限。
deepseek-flash 提供 1M Token的上下文窗口,单次请求的最大输出上限为 384K(对应参数上限 393216)。在迁移原有代码时,很多团队会沿用旧模型写死的 max_tokens 或直接留空依赖默认行为,这在切换后会直接影响长文本生成或长链路推理的完整性。因为 deepseek-flash 的默认 max_tokens 会随思考模式的档位动态变化,且输入 Token 与输出 Token 的总和必须严格控制在 1M 上下文窗口之内。如果在变更模型后需要对比不同接口返回的字段差异,可以参考API 响应结构差异对比,提前在测试环境核对响应体结构。
思考模式参数与输出上限的联动机制
Chat Completions API 参考默认开启思考模式,可通过 reasoning_effort 或 thinking.type 控制。未指定这两个参数时,默认思考档位为 high。本文示例只设置 reasoning_effort,避免在同一请求中给出相反的开关值。
为了避免配置冲突,建议在迁移时对照以下参数规则逐项设定:
- reasoning_effort:支持 none、low、high、max 四个档位,默认值为 high。将该参数设为 none 会直接关闭思考模式。
- thinking.type:支持 enabled 与 disabled 两个选项,默认值为 enabled。
- max_tokens 取值范围与默认值:允许显式传入 1 到 393216 之间的整数。当未显式传入 max_tokens 时,关闭思考模式下的默认输出上限为 8K;常规思考模式(如默认 high 档位)下的默认输出上限为 64K;而将 reasoning_effort 设为 max 时,默认输出上限会提升至 128K。
如果你的业务场景只是需要快速完成结构化提取或简短问答,不需要模型输出长篇推理过程,可以在请求体中显式传入 “reasoning_effort”: “none” 或将 thinking.type 设为 disabled,否则每次请求都会默认按 high 档位执行思考。反之,如果业务确实依赖深度思考,建议根据预估的推理链加最终回复长度显式指定 max_tokens,不要完全依赖默认值,同时确保历史消息加上 max_tokens 不会触发 1M 上下文越界。
采样参数失效与工具调用的 400 报错边界
将旧版 OpenAI 兼容代码切换到 deepseek-flash 时,最容易引发线上异常的是采样参数与工具调用(Tool Calling)在思考模式下的严格限制。许多现有集成代码习惯在请求体中固定附带 temperature(例如设为 0.2 或 0.7),并在需要结构化输出或强制执行函数时设置 tool_choice。
在 deepseek-flash 的思考模式下,这两类参数存在明确的边界条件:
- temperature 参数失效:只要请求处于思考模式(无论是默认开启,还是显式指定了 low、high、max),传入的 temperature 均不会生效。在该模式下,降低 temperature 不能用于调整输出随机性。
- tool_choice 强制约束返回 400 错误:在思考模式下,如果将 tool_choice 设置为 “required”,或者通过对象格式强制指定调用某一个具体工具(named tool choice),接口会直接拒绝请求并返回 HTTP 400 状态码。
因此,如果你的工作流既需要开启思考模式,又挂载了外部工具列表 tools,就必须将 tool_choice 保持为默认的自动选择状态(或不传该字段),让模型在思考过程中自行判断是否调用工具。如果某个业务环节必须强制模型调用特定函数,你有两种迁移路径:一是在该次请求中将 reasoning_effort 设为 none 关闭思考模式,从而保留 tool_choice: “required” 或指定工具名称的能力;二是在保持思考模式的前提下移除强制 tool_choice 约束,并在业务层面对模型未调用工具的返回结果做兜底校验。关于上游接口异常状态与返回结果的防御性处理,可以结合 AI 分类器的失败与恢复处理中的思路来设计降级逻辑。
请求示例与参数改写对照
下面是根据官方对话补全文档改写的最小请求。HTTP 块中的 $DEEPSEEK_API_KEY 是占位符,实际由服务端客户端从环境变量读取。
POST https://api.deepseek.com/chat/completions
Authorization: Bearer $DEEPSEEK_API_KEY
Content-Type: application/json
{
"model": "deepseek-flash",
"messages": [
{
"role": "user",
"content": "Explain this error message."
}
],
"reasoning_effort": "high",
"max_tokens": 4096
}在这份请求体中,model 使用了标准别名 deepseek-flash,并显式声明了 “reasoning_effort”: “high” 与 “max_tokens”: 4096。这样写的好处是既明确了思考档位,又把单次输出预算控制在业务预期的 4096 Token 内,避免直接使用 64K 默认值导致网关层超时估算失准。
本地与预发环境的检查步骤
迁移后,在自己的测试环境中检查以下项目:
- 全局检索代码库与配置中心,确认所有原本打算指向 DeepSeek-V4.1-Flash-1017 的请求均已统一写为 “model”: “deepseek-flash”,且基础 URL 指向 https://api.deepseek.com。
- 审查所有包含 tools 的调用点:凡是未显式设置 “reasoning_effort”: “none” 或 “thinking”: {“type”: “disabled”} 的请求,一律移除 tool_choice: “required” 及指定工具名称的强制配置,防止上线后触发 HTTP 400 错误。
- 检查长文本与流式处理逻辑,确认客户端超时时间能够容纳思考模式下的推理耗时,并根据任务类型显式补全 reasoning_effort 与 max_tokens(在 1 至 393216 范围内),随后使用测试密钥发起一次最小化请求,核对返回状态码及字段完整性。