MOSS-Image 布局 JSON:将 UI 坐标转换为中心化 yxyx
将网页或设计稿中的左上角像素框转换为 MOSS-Image 实验性布局 JSON 的中心化 yxyx 坐标,并对照官方 Diffusers 推理调用参数完成校验。
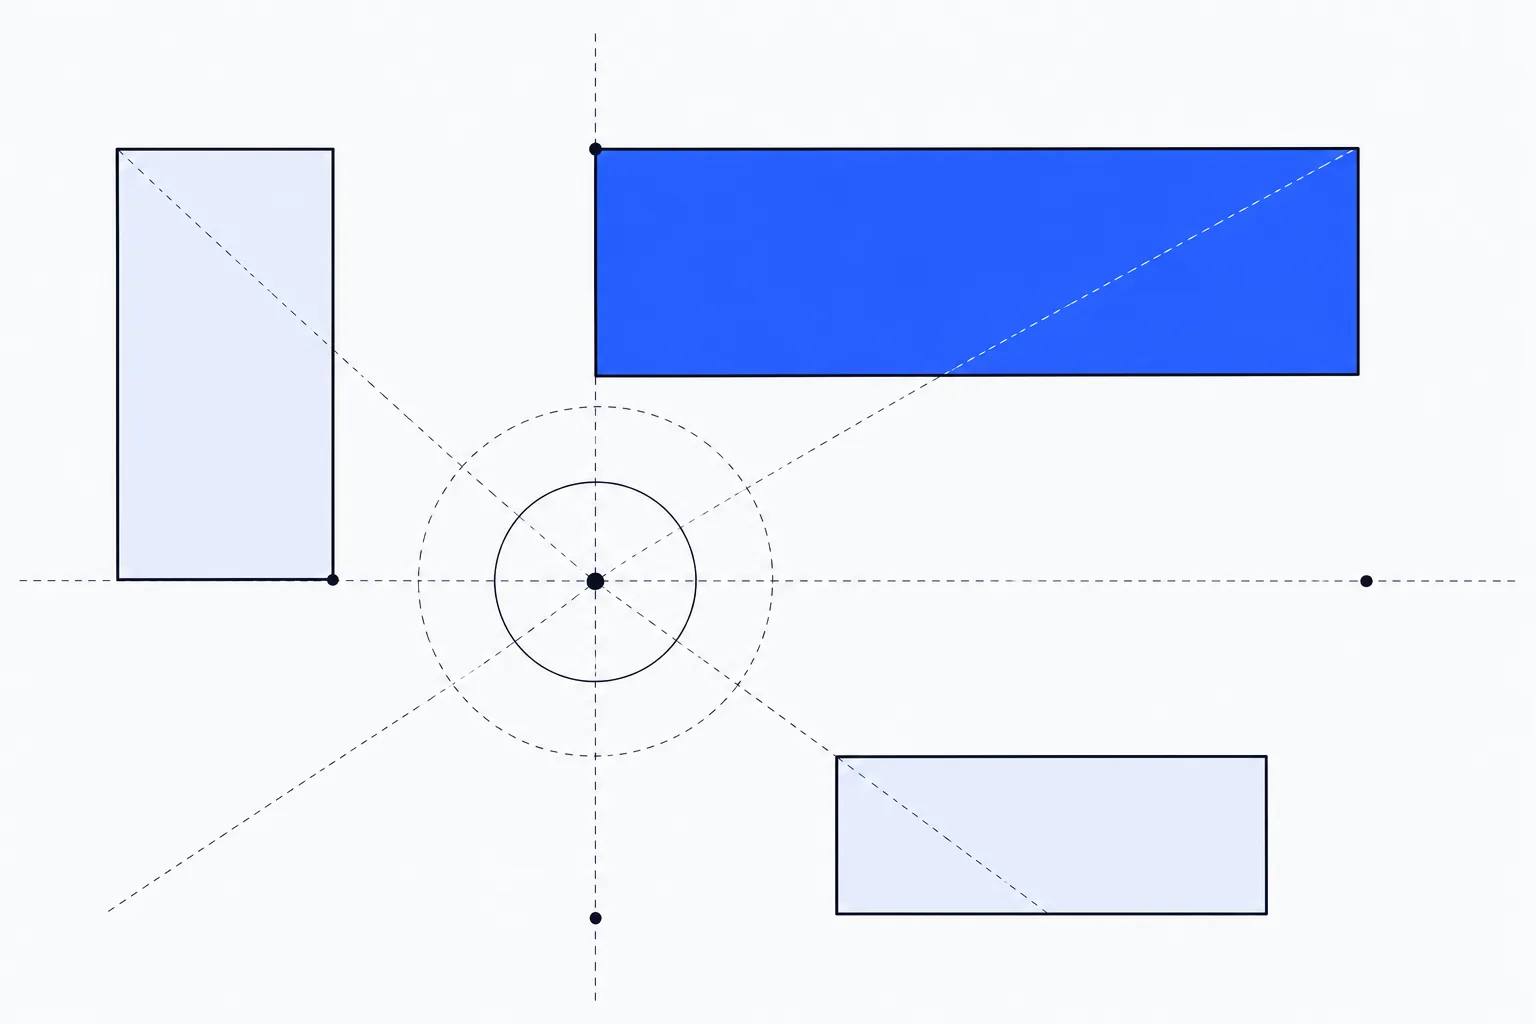
把设计稿中的文本框转成 MOSS-Image 布局提示词前,先核对原点和坐标顺序。前端常用左上角原点的 xyxy 或 xywh,MOSS-Image 的实验性布局格式使用画布中心原点,并按 yxyx 排列。下面用一张 1024 × 1024 画布上的标题框,完成坐标转换、JSON 组装和推理参数对照。
本文依据官方文档整理,未安装模型、执行 GPU 推理或调用付费 API。
Base 与 SFT 权重分工及推理管线约束
根据 MOSS-Image 官方仓库的说明,该项目采用 5B 参数规模的图像主干网络,最高支持 4K tokens 的文本提示词输入(官方描述为“Accept text prompts of up to 4K tokens.”),布局 JSON 也计入这份提示词长度预算。官方同批公开了 Base 与 SFT 两套模型权重,在工程接入时需要明确区分两者的职责边界。Base 权重面向基础生成、研究探索以及后续微调,官方关于实验性布局提示词与详细采样参数的指南均围绕 OpenMOSS-Team/MOSS-Image-Base 展开;如果你计划在 Base 权重之上做后训练(post-training),官方明确要求冻结文本编码器(freeze the text encoder)。SFT 权重由 Base 在精选数据上微调得到。
MOSS-Image 官方仓库中的模型与布局能力说明。
对于长提示词与复杂布局,MOSS-Image 用户指南 给出了明确的画布与采样约束。画布的宽(width)和高(height)必须取 16 的正整数倍(“use positive multiples of 16”),官方推荐的总像素规模集中在 1M、1.5M 与 2M 三个档位。在采样端,Base 模型指南建议至少使用 50 步推理(num_inference_steps=50),引导系数 guidance_scale(CFG)推荐设为 3.0(合理区间为 3 到 6),搭配 Euler 调度器并将 shift 设为 5。此外,仓库中的独立管线代码采用 Apache-2.0 许可证,但在将模型投入商业或分发环境前,不能把代码许可证直接等同于全部模型权重的授权,仍需单独核查权重仓库的许可证条款。
将左上角 UI 像素框转换为 abs_centralized 与 yxyx 格式
设画布宽为 W、高为 H。将左上角原点的像素坐标转换成中心原点坐标时:
x_centered = x - W / 2
y_centered = y - H / 2
bbox = [y_min_centered, x_min_centered, y_max_centered, x_max_centered]
在 1024 × 1024 画布上,两轴范围都是 -512 到 512。假设标题框的左上角为 (128, 96),右下角为 (896, 224),转换如下:
| 分量 | 计算 | 结果 |
|---|---|---|
| y_min | 96 - 512 | -416 |
| x_min | 128 - 512 | -384 |
| y_max | 224 - 512 | -288 |
| x_max | 896 - 512 | 384 |
最终 bbox 为 [-416, -384, -288, 384]。bbox_coord_space 设为 "abs_centralized",表示中心原点的绝对像素坐标;bbox_format 设为 "yxyx",表示四个分量的顺序。关于坐标表示与原点处理,也可参照多尺度 WebGL 坐标精度。
将这些计算结果填入官方 USERGUIDE 定义的 JSON 结构后,完整的布局提示词对象如下(基于官方文档示例整理,未实际执行模型生成):
{
  "summary": {
    "caption": "The word BUILD at the top of a white poster."
  },
  "items": [
    {
      "label": "text",
      "caption": "Title at top",
      "text": "BUILD",
      "bbox": [
        -416,
        -384,
        -288,
        384
      ]
    }
  ],
  "bbox_coord_space": "abs_centralized",
  "bbox_format": "yxyx"
}
在这个结构中,summary.caption 负责描述整张画面的全局背景与构图关系,items 数组则逐个声明局部元素。每个文本元素包含四个关键属性:label 标记元素类型(此处为 “text”),caption 描述该元素的局部视觉特征或位置角色,text 指定需要渲染的具体字符内容,bbox 则传入刚刚算出的中心化 yxyx 整数坐标。需要注意,官方明确标注该布局支持目前处于实验性阶段(Experimental),在复杂多元素交叠场景下不应将其视为百分之百像素级对齐的硬性排版引擎。
官方 Diffusers 推理调用与布局注入方式
当你在具备 PyTorch 与 CUDA 的环境中调用模型时,MOSS-Image 通过 Hugging Face diffusers 的自定义管线机制加载。由于开启了 trust_remote_code=True 以拉取远端的 pipeline_moss_image 实现,在接入生产或内部受控环境前,应当先审阅远端仓库中的自定义管线源码。同时,本文核对的资料未能确定通用的最低显存要求,以下来自 MOSS-Image 官方 Python 快速开始的精确参考代码仅供接口对照(文档示例,本次未在本地运行或触发 GPU 推理):
import torch
from diffusers import DiffusionPipeline

pipe = DiffusionPipeline.from_pretrained(
    "OpenMOSS-Team/MOSS-Image-Base",
    custom_pipeline="pipeline_moss_image",
    trust_remote_code=True,
    torch_dtype={"default": torch.bfloat16, "vae": torch.float32},
)
pipe.scheduler = type(pipe.scheduler).from_config(pipe.scheduler.config)
pipe.to("cuda")
image = pipe(
    "A wide view of a refrigerator beside a kitchen counter with a fruit bowl. A small sticky note on the refrigerator door is handwritten in Chinese:“\n记得买牛奶和鸡蛋!\n牛奶两盒,鸡蛋一打。\n顺便带一袋面包。”",
    height=1456,
    width=1456,
    num_inference_steps=50,
    guidance_scale=3.0,
    uncond_skip_layers=[22],
    generator=torch.Generator("cpu").manual_seed(42),
).images[0]
image.save("refrigerator_note.png")
观察这段官方调用可以发现几个关键实现细节:torch_dtype 传入了一个字典,将主干默认精度设为 torch.bfloat16,同时将 vae 保持为 torch.float32;画布尺寸 1456 × 1456 约合 212 万像素(属于 2M 像素推荐档位),且 1456 = 16 × 91,严格满足 16 的正整数倍要求;此外还显式指定了 uncond_skip_layers=[22]。
如果要将上文构造的实验性布局 JSON 送入该管线,保留初始化方式,将传入 pipe(…) 的第一个位置参数(原本的自然语言字符串)替换为 json.dumps(layout, ensure_ascii=False) 生成的 JSON 字符串,并确保你在计算 bbox 时使用的画布宽高 W、H 与调用 pipe 时传入的 width、height 参数完全一致。例如,为上面的布局调用管线时,应同时设 width=1024、height=1024,使像素偏移与画布一致。
在启动 GPU 推理前静态检查转换结果
为了避免因坐标顺序写反或画布尺寸失配而浪费长达 50 步的 GPU 采样时间,建议在将 JSON 字符串交给 pipe 之前,在业务代码中加入一段纯 CPU 的坐标转换与断言检查函数。下面是本文自编的纯 Python 辅助函数,只接收整数像素框,用来验算上述坐标;它不加载模型:
import json

def build_and_verify_moss_layout(width: int, height: int, summary_caption: str, ui_items: list) -> str:
    if type(width) is not int or type(height) is not int:
        raise ValueError("Canvas dimensions must be integer pixels.")
    if width <= 0 or height <= 0 or width % 16 != 0 or height % 16 != 0:
        raise ValueError(f"Canvas dimensions ({width}x{height}) must be positive multiples of 16.")

    half_w = width // 2
    half_h = height // 2
    moss_items = []

    for item in ui_items:
        x_min, y_min, x_max, y_max = item["ui_bbox_xyxy"]
        if not (0 <= x_min < x_max <= width and 0 <= y_min < y_max <= height):
            raise ValueError(f"UI bbox {item['ui_bbox_xyxy']} is out of {width}x{height} bounds.")

        if any(type(value) is not int for value in item["ui_bbox_xyxy"]):
            raise ValueError("Use integer pixel coordinates for this helper.")

        bbox_yxyx = [
            y_min - half_h,
            x_min - half_w,
            y_max - half_h,
            x_max - half_w,
        ]

        assert -half_h <= bbox_yxyx[0] < bbox_yxyx[2] <= half_h, "Invalid Y range in yxyx"
        assert -half_w <= bbox_yxyx[1] < bbox_yxyx[3] <= half_w, "Invalid X range in yxyx"

        moss_items.append({
            "label": item["label"],
            "caption": item["caption"],
            "text": item["text"],
            "bbox": bbox_yxyx,
        })

    payload = {
        "summary": {"caption": summary_caption},
        "items": moss_items,
        "bbox_coord_space": "abs_centralized",
        "bbox_format": "yxyx",
    }
    return json.dumps(payload, ensure_ascii=False, indent=2)

# 验证 1024x1024 画布下 UI 坐标 [128, 96, 896, 224] 是否精确产出本文示例的 [-416, -384, -288, 384]
verified_json = build_and_verify_moss_layout(
    width=1024,
    height=1024,
    summary_caption="The word BUILD at the top of a white poster.",
    ui_items=[
        {
            "label": "text",
            "caption": "Title at top",
            "text": "BUILD",
            "ui_bbox_xyxy": [128, 96, 896, 224],
        }
    ],
)
print(verified_json)
这次本地执行该函数,输出的 bbox 为 [-416, -384, -288, 384];非 16 倍数画布、反向边界框、浮点坐标和浮点画布尺寸四类输入均被拒绝。模型未加载。
这段检查逻辑校验了三类输入条件:首先校验 width 和 height 是否满足 16 的正整数倍;其次检查输入的左上角 xyxy 坐标是否满足左小于右、上小于下且未越界;最后在减去半高与半宽并重排为 [y_min, x_min, y_max, x_max] 后,验证第 0 项严格小于第 2 项(纵向跨度有效)、第 1 项严格小于第 3 项(横向跨度有效),且全部落在 [-W/2, W/2] 与 [-H/2, H/2] 区间内。
现在,你可以直接把项目前端导出的标注框数组传入 build_and_verify_moss_layout,核对打印出的 bbox 数值是否与目标分辨率(例如 1024 × 1024 或 1456 × 1456)匹配,并在审阅完 pipeline_moss_image 远端管线代码与权重许可证后,将生成的 JSON 字符串接入 CUDA 推理环境。