在用 Muse Wonder 处理私有代码前,先理清 Contributor 模式与 API 边界
基于公开官方说明,梳理 Muse Code 订阅中的 Contributor 模式默认值、关闭后的前向生效边界,以及 Muse Wonder 与 Wonder Full 在 CLI 订阅和 Model API 按量付费之间的可用性差异。
把包含私有仓库上下文的编码任务交给模型之前,开发者需要先做两个前置判断:第一,即将发出的代码片段和上下文是否会被平台用于模型训练;第二,当前选择的接入入口是否支持你所需要的模型规格与数据模式。
设想一个典型的假设场景:你正在维护一个未公开的后端服务仓库,打算借助 Muse Wonder 系列模型 高达 1,048,576 的上下文窗口,一次性把跨模块的接口定义、鉴权逻辑和报错日志发给模型做重构分析。在敲下回车或发起请求前,如果没弄清订阅默认设置与 API 按量付费(PAYG)的边界,很容易在不知情的状态下把内部代码送进训练流水线,或者在选错入口后发现目标模型根本无法调用。
下文按公开官方资料整理选择顺序。账号内的设置操作、实际用量、数据保留与删除流程和模型 benchmark 都没有在本次测试中展开,因此只讨论文档直接说明的训练与入口边界。
第一步:看清 Muse Code 订阅的默认 Contributor 模式与前向边界
如果你选择通过 Muse Code 订阅来使用模型,首先要关注的是数据训练条款。根据 Muse Code 订阅官方文档,Muse Code subscriptions 默认开启 Contributor mode(注意官方名称是 Contributor mode,不要将其误称为 Privacy mode)。
在 Contributor mode 下,用户以允许平台使用提交内容来交换更高的使用额度,Meta 会将你提交的内容用于训练模型。官方明确列出的覆盖范围非常完整,包括:
- 提示词(prompts)
- 代码(code)
- 文件与上下文(files/context)
- 模型生成回复(model responses)
这意味着在默认状态下,你放进上下文窗口的仓库代码、配置文件以及模型针对这段代码给出的修改建议,全部属于可被用于训练的范畴。
官方文档说明可以在 Muse Code settings 中关闭 Contributor mode。对私有代码,关键在于它的前向生效原则:
- 关闭 Contributor mode 后,只有未来新提交的内容才不会被用于模型训练(前提是你随后没有重新开启该模式)。
- 如果你在关闭之前已经提交过私有代码或上下文,官方材料没有说明过去已提交的内容会被删除或从训练集中撤回。因此,任何工程团队都不能把“事后补关设置”当作撤回历史数据的补救手段。
换句话说,对于不允许进入外部训练集的私有仓库,检查并关闭 Contributor mode 必须发生在第一次发送含敏感上下文的请求之前。
第二步:区分 Muse Wonder 与 Wonder Full 的入口边界
理清训练条款之后,第二个现实约束是:你想用的模型变体和计费方式,是否支持你偏好的工具链入口。
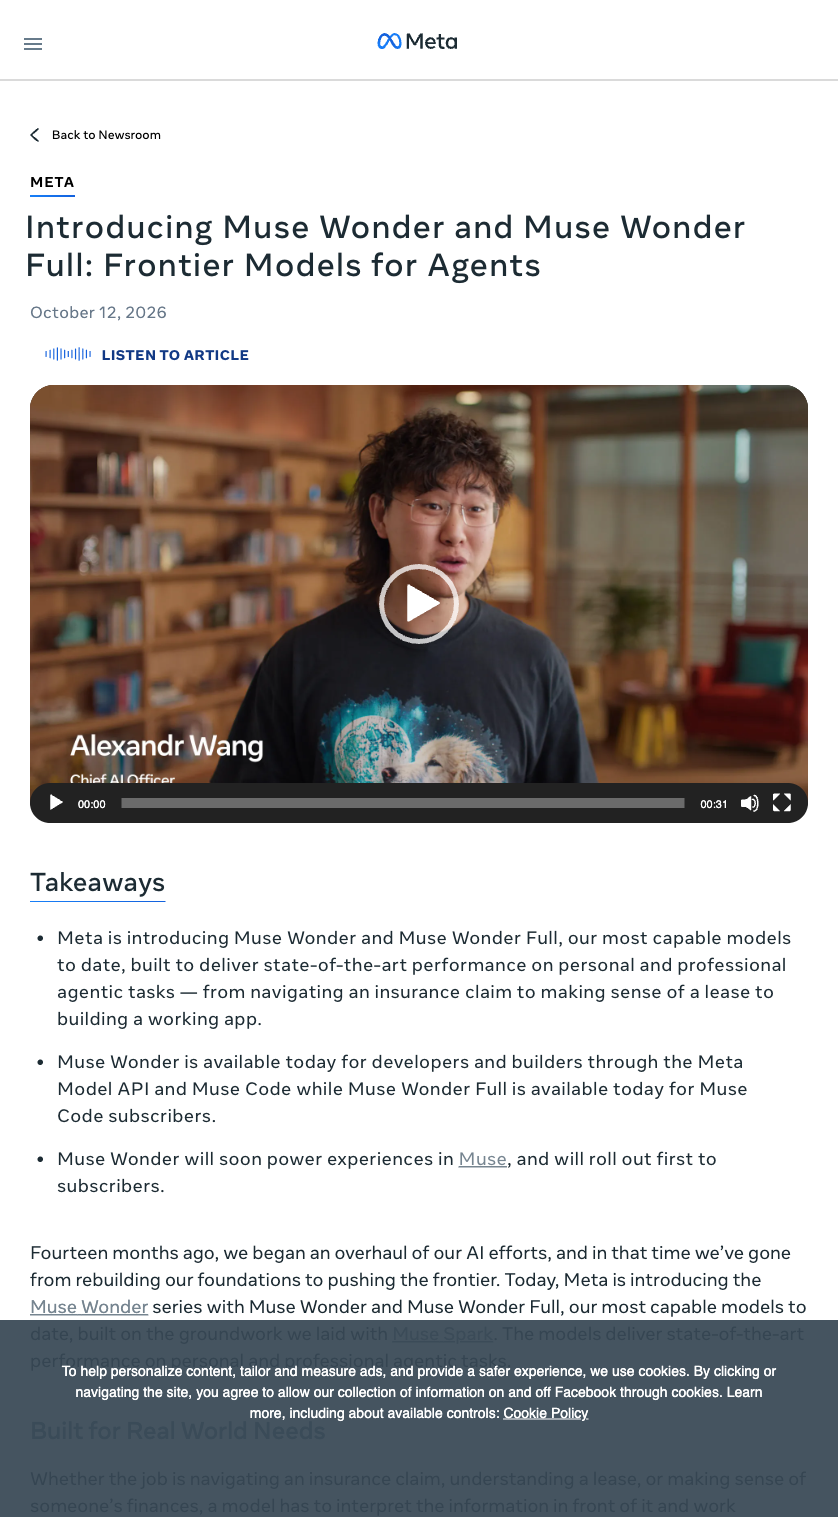
官方英文发布页面概览 Muse Wonder 系列。
结合 Meta 模型官方文档 与订阅说明,当前 Muse Wonder 被标为 preview 状态,具备 1,048,576 上下文窗口,并支持从 minimal 到 max 的推理(reasoning)档位调节;同时需要注意,Model API 的可用性受国家或地区影响,官方文档明确排除了韩国(South Korea)。
更重要的是,Muse Wonder 与 Wonder Full 在订阅计划和 Model API PAYG 之间存在严格的通道隔离:
- 订阅计划内的模型分配:基础的 Wonder 包含在每一个 Muse Code subscription plan 中;而 Wonder Full 仅在 Power Usage 和 Maximum Usage 订阅计划中提供。在包含对应模型的计划内,开启或关闭 Contributor 这两种模式都可以使用。
- 订阅的客户端限制:Muse Code subscriptions 仅通过登录了 Meta Model API 账号的 Muse Code CLI 运作。它并不是一个通用 API key 的替代品,不能直接拿去填进无关的第三方客户端或自建路由服务里调用。
- Model API 的 PAYG 边界:如果你通过 Model API 采用按量付费(PAYG)方式调用 Muse Wonder,该通道仅提供 Standard mode only(即不走用数据换额度的 Contributor 模式)。同时,Wonder Full 不通过 Model API 提供。此外,评估成本与配置时请严格查阅对应文档,不要把其它模型(如 Spark Contributor)的模型 ID 或费率套用到 Wonder 上。
如果你平时习惯用自定义的编码代理或路由层分发请求(可参考我们此前关于编码代理路由成本与质量测试的讨论),就会立刻发现这里的架构约束:想把请求接进自有 API 网关,你只能使用 Model API PAYG 下的 Standard mode 调用 Muse Wonder,无法通过该 API 获得 Wonder Full;反过来,如果你必须使用 Wonder Full,就只能绑定在支持该模型的 Muse Code 订阅计划(Power Usage 或 Maximum Usage)及 Muse Code CLI 工作流内。
三种常见使用方式核心差异对比
为了方便在项目启动前快速核对,下面把官方材料能够证实的三种路径整理为对照表:
| 对比维度 | 订阅内开启 Contributor mode | 订阅内关闭 Contributor mode | Model API PAYG(Standard mode) |
|---|---|---|---|
| 是否为订阅默认状态 | 是(Muse Code 订阅默认开启) | 否(需在 Muse Code settings 中关闭) | 不适用(API PAYG 仅支持 Standard mode) |
| 提交内容是否用于训练 | 是,覆盖 prompts、code、files/context 与 model responses | 关闭后仅未来提交内容不用于训练(除非重开);官方未承诺删除或撤回历史已提交内容 | Standard mode only(非 Contributor 模式) |
| 可用模型范围 | Wonder(所有订阅计划);Wonder Full(仅限 Power Usage 与 Maximum Usage) | Wonder(所有订阅计划);Wonder Full(仅限 Power Usage 与 Maximum Usage) | 仅支持 Muse Wonder;不提供 Wonder Full |
| 调用入口与限制 | 仅通过登录 Meta Model API 账号的 Muse Code CLI 运作,非通用 API key 替代品 | 仅通过登录 Meta Model API 账号的 Muse Code CLI 运作,非通用 API key 替代品 | 通过 Model API 按量调用(可用性受国家限制,明确排除韩国) |
开发者落地判断顺序
回到文章开头的假设场景,当你准备让 Muse Wonder 处理一段仓库代码时,可以按以下三步顺序完成决策,无需依赖任何复杂的猜测:
1. 先按训练容忍度划分待发送的上下文
先把你要发送的内容拆开看:里面是否包含私有业务逻辑、未公开接口或内部配置?
- 如果这批 prompts、code、files/context 连同未来的 model responses 完全可以公开或允许用于模型训练,那么订阅默认的 Contributor mode 可以直接为你换取更多使用额度。
- 如果这批内容属于不可用于外部训练的私有资产,你必须在发出第一条请求前排除 Contributor mode——因为一旦在开启状态下发出了请求,事后关闭设置也无法获得官方对历史数据删除或撤回训练的承诺。
2. 根据目标模型与工具链选择入口
确定数据边界后,再看你需要哪个模型级别和调用工具:
- 需要在自有工具或网关里走 API 调用:直接选择 Model API 的 PAYG 入口。它天然是 Standard mode only,但你要接受两个前提——所在地区支持 Model API(例如不在被明确排除的韩国),且任务只需要 Muse Wonder(preview,1,048,576 上下文,支持 minimal 到 max reasoning),不需要 Wonder Full。
- 任务必须用到 Wonder Full,或希望使用订阅额度:你必须使用绑定了 Meta Model API 账号的 Muse Code CLI,并且确保订阅档位在 Power Usage 或 Maximum Usage(若只需基础 Wonder,则任一订阅计划均可)。
3. 在发送代码前核对 Muse Code 设置
如果你最终选择了 Muse Code CLI 订阅路径来处理不可用于训练的代码,请在把工作目录或文件上下文交给 CLI 之前,先进入 Muse Code settings 将 Contributor mode 关闭,并在后续团队协作中确保该开关不会被意外重新打开。
Contributor mode 与 Standard mode 说明的是提交内容是否按公开条款用于训练。无论选择哪条路径,密钥、凭据和生产机密都应先在本地脱敏与隔离,再发送必要的上下文。