Qwen-Image-2.1-Turbo 接入:为什么只改推理步数不生效
用 QwenImage21Pipeline 加载 Turbo 权重,保留自带的 8 步采样调度,核对 Diffusers 依赖、KV 缓存和图片编辑输入。
把现有 Diffusers 脚本换成 Qwen/Qwen-Image-2.1-Turbo 后,先检查管线是否读到了权重自带的采样调度。这个版本把推荐的 8 步调度一起保存进了 checkpoint;按照官方模型卡,只传 num_inference_steps 不会覆盖它。
这会影响常见的迁移方式:旧脚本可能统一传入 num_inference_steps=30,日志也把请求参数记成 30,但实际调度仍取自 checkpoint。接入时应该先跑通官方默认配置,再决定要实验哪些参数。下面按官方文档整理加载与检查步骤,未在本机执行模型推理,因此没有速度、显存或画质实测数据。
先确认管线和依赖
Turbo 是 Qwen-Image-2.1 的加速 checkpoint,官方介绍为 7B 视觉生成架构,支持文生图与图片编辑,使用 QwenImage21Pipeline 加载。模型卡要求兼容 CUDA 的 PyTorch,并给出以下安装方式:
pip install git+https://github.com/huggingface/diffusers.git
pip install "transformers>=5.17.0" accelerate pillow
这里直接安装 Diffusers 源码有具体原因:需要包含 PR #14950 引入的管线采样 sigmas 支持。若旧环境无法导入 QwenImage21Pipeline,先核对实际安装版本和当前 Python 环境,继续改生成参数解决不了缺少管线的问题。
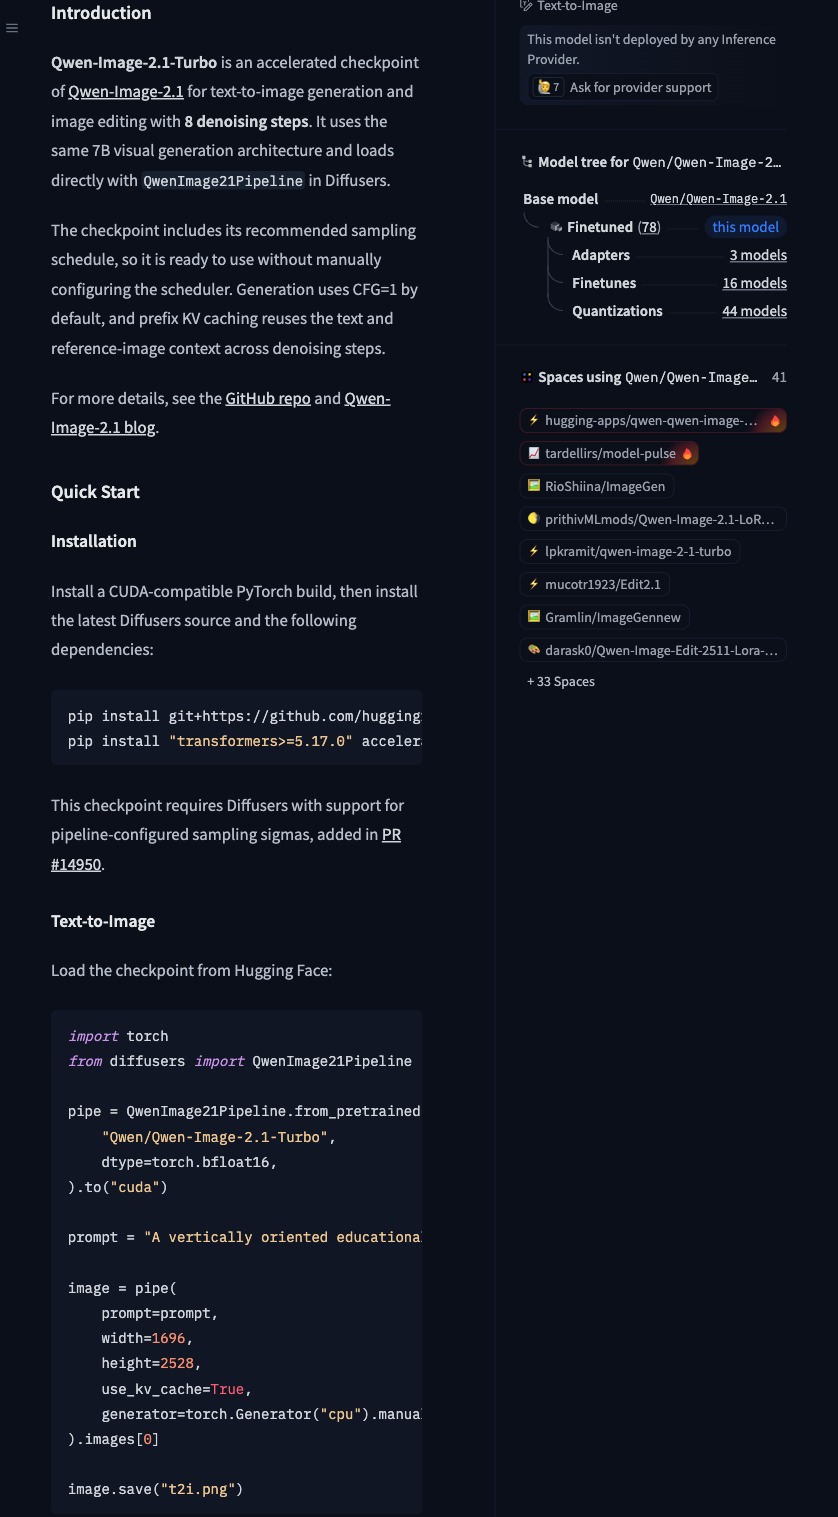
Qwen 官方模型卡列出了 8 步调度、KV 缓存和所需依赖。完整命令见正文。
安装验证通过后,把 PyTorch、Diffusers 和 Transformers 的实际版本记录到自己的运行记录中。由于源码安装会随上游变化,后续复现还需要保留所用提交。模型卡没有在这里给出经过核验的最低显存门槛,不能仅凭“7B”推算一张显卡一定装得下。
用默认调度建立第一份输出
下面沿用官方文生图调用,缩短了示例提示词;这是一段文档适配示例,图片内容与效果尚未验证。
import torch
from diffusers import QwenImage21Pipeline

pipe = QwenImage21Pipeline.from_pretrained(
    "Qwen/Qwen-Image-2.1-Turbo",
    dtype=torch.bfloat16,
).to("cuda")

prompt = (
    "A portrait editorial illustration of a small blue bicycle "
    "beside a white wall, soft daylight, generous empty space."
)

image = pipe(
    prompt=prompt,
    width=1696,
    height=2528,
    use_kv_cache=True,
    generator=torch.Generator("cpu").manual_seed(42),
).images[0]

image.save("t2i.png")
这份调用保留了三个容易在封装层丢掉的设置:
- 明确加载
QwenImage21Pipeline,使 checkpoint 的配置由相应管线读取。 - 保留默认采样调度,不加一组从其他模型复制的
sigmas。 - 开启
use_kv_cache=True,按官方说明在去噪步骤间复用文本和参考图的上下文。
模型默认 CFG 为 1。第一次接入先使用这套默认组合,保存提示词、seed、宽高、依赖版本和实际输出,再做同条件比较。固定 seed 有助于控制一次比较的变量,但不同硬件和依赖版本下的逐像素一致性仍需自己核验。
步数参数和采样调度要分开记录
num_inference_steps 是你传给调用的参数;sigmas 描述每一步使用的噪声水平。Turbo 的推荐调度已经保存在 checkpoint 中,官方明确说明:单独设置前者不会覆盖保存的调度。若你正在做统一图片生成服务,界面上显示的“步数”应能追溯到实际采用的调度,避免把请求值当成执行值。
显式传入调用时的 sigmas 可以覆盖 checkpoint 调度,但官方尚未评估这个 checkpoint 在其他调度下的表现。需要实验时,把它作为独立配置保留,比较同一提示词、seed、分辨率下的输出;不要把“成功生成文件”直接记录成“质量与默认版本一致”。
如果还在接入其他生成模型,可以对照 FLUX 3 Image Klein 的蒸馏推理配置。两者都需要核对模型专属默认值,FLUX 的 prompt upsampler 与这里的采样调度承担不同职责,不能直接互换参数。
切换到图片编辑
官方编辑示例复用同一个管线,把参考图转换为 RGBA 后传入 image,输出尺寸采用 2048 × 2048。下面将官方在线样本替换为你自己的本地文件,保留调用结构:
from PIL import Image

input_image = Image.open("input.png").convert("RGBA")

image = pipe(
    prompt="Keep the object shape and replace the background with a plain blue wall.",
    image=input_image,
    width=2048,
    height=2048,
    use_kv_cache=True,
    generator=torch.Generator("cpu").manual_seed(42),
).images[0]

image.save("edit.png")
RGBA 是输入处理方式;这段代码没有要求输出背景透明,也没有保证原图每个边缘都会被保留。检查输出时,应把主体形状、文字、遮挡和边缘分别与输入比较。若需要把输出做成固定尺寸的网页素材,可继续阅读 1024 × 1024 图片的裁剪与补边方法。
官方给出的横向 16:9 预设为 2752 × 1536,纵向 9:16 为 1536 × 2752;方图为 2048 × 2048。先从相应预设开始,比任意缩放宽高更容易与官方例子对照。
发布或商用集成前,还需核对 Qwen Research License Agreement 对用途的具体约束。模型卡标注的是 qwen-research。本篇完成的是接入参数梳理;在你自己的 GPU 上得到第一份输出后,再补上实际耗时、显存和同任务画质比较,才有依据决定是否替换现有生成链路。